Delegar sin abdicar: agentes de inteligencia artificial para el control externo gubernamental
Trabajo presentado al XXVIII Congreso Nacional del Secretariado Permanente de Tribunales de Cuentas, Órganos y Organismos Públicos de Control Externo de la República Argentina (Ciudad Autónoma de Buenos Aires, 2026), en el marco del IETEI.
Lo publico completo, tal como se presentó: es la descripción metodológica de cómo trabajamos hoy con agentes de IA en una auditoría real, y de dónde ponemos el límite.
- Autor
- Luis Villegas
- Organismo
- Auditoría General de la Provincia de Salta — Área de Control III (AGPS)
- Eje temático
- Eje 2 — Innovación Tecnológica e Inteligencia Artificial (Control 4.0)
1. Resumen
El método convencional de auditoría gubernamental (criterio técnico transmitido oralmente, procedimientos repetidos a mano, supervisión de calidad por lectura manual) no escala frente a expedientes cada vez más voluminosos. El presente trabajo describe un framework de auditoría construido sobre agentes de inteligencia artificial, en el que ese conocimiento técnico se codifica en unidades reutilizables, versionables y auditables, análogas a los módulos y reglas de negocio de un equipo de software. Se documenta su aplicación en un caso ilustrativo compuesto —la auditoría de la Cuenta General de un municipio ficticio ("LA MUNICIPALIDAD")— que aborda el cotejo bancario automatizado con análisis asistido por el auditor, el control estructural de hallazgos y la memoria de supervisión de calidad, además de una capa opcional de gestión visual para equipos con mayor interés técnico.
El trabajo propone este vocabulario (reglas, skills, agentes de rol) como una arquitectura adoptable por otros organismos de control externo, y expone con honestidad su principal límite: la tensión entre la neutralidad exigida al producto final de auditoría y la transparencia sobre el uso de IA que exige hoy la comunidad académica. El hallazgo central, y principio rector de todo el trabajo, es que el framework automatiza tareas, no delega la responsabilidad profesional: libera al auditor de lo mecánico para que concentre su tiempo en el análisis de causa, siempre que se mantenga una arquitectura de responsabilidad humana explícita, trazable y verificable en cada etapa.
Palabras clave: auditoría gubernamental, inteligencia artificial, agentes, control externo, automatización de procesos, Control 4.0.
2. Introducción: un lunes cualquiera de trabajo de auditoría
Son las ocho y media de la mañana y la carpeta del expediente ya está abierta en dos pantallas. En una, el legajo papel escaneado de la Cuenta General del municipio bajo examen: más de tres mil fojas entre mayores contables, extractos bancarios, resoluciones, contratos de obra y descargos. En la otra, una consulta a una base de datos que tardó cuarenta segundos en construirse y que hace un año hubiera llevado media tarde de copiar y pegar celdas en una planilla de cálculo.
Quien haya trabajado en un organismo de control externo conoce bien la escena que sigue: alguien del equipo detecta una diferencia de saldo entre el libro mayor de una cuenta bancaria y el extracto del banco correspondiente a un mes puntual. La pregunta se repite siempre igual: ¿es una omisión real de registración, o una anulación bancaria que se compensa sola? Responderla exige repetir, mes tras mes y cuenta tras cuenta, el mismo procedimiento mental: sumar, contrastar, buscar el importe exacto en direcciones opuestas, descartar hipótesis, documentar la conclusión. Es un trabajo humano en su criterio y mecánico en su ejecución.
Este trabajo parte de ahí. No es una reflexión abstracta sobre "la inteligencia artificial en la auditoría"; es el relato metodológico de una decisión concreta, dejar de tratar cada papel de trabajo como un documento aislado que se escribe desde cero, y empezar a tratar el conjunto del proceso de auditoría como se trata un sistema de software: un conjunto de componentes reutilizables, con una especificación clara de qué debe hacer cada uno, sometidos a control de versiones. Un elemento central de ese enfoque es la capa de supervisión humana que audita al propio proceso automatizado, tal como un revisor de código humano audita lo que produce una herramienta de análisis estático.
Antes de continuar, una aclaración de vocabulario. Este trabajo usa a propósito, sin traducir, ciertos términos técnicos de la ingeniería de software y de agentes de inteligencia artificial, de la misma manera en que "software", "hardware" o "email" ya forman parte del vocabulario cotidiano en español sin necesidad de traducción: apropiarse del término original facilita el diálogo con la bibliografía especializada citada a lo largo de este trabajo, en lugar de forzar traducciones que generarían más confusión que claridad. El glosario incluido más adelante (Tabla 1) reúne todos estos términos con su significado.
Esa analogía con la ingeniería de software, tomando prestado el concepto de infrastructure as code bajo la forma de lo que aquí podría llamarse audit as code, tiene una traducción operativa concreta, descripta en la Sección 4. Las normas y criterios que un auditor senior transmitiría oralmente a un junior durante meses de trabajo compartido se escriben como reglas persistentes. Los procedimientos técnicos repetibles (un cotejo bancario, la redacción de una hoja de hallazgos, el armado de una memoria de supervisión) se escriben como skills, unidades de conocimiento invocables y versionadas. Y los distintos roles de un equipo de auditoría (el especialista en obras públicas, el abogado que analiza la legalidad de un contrato, el revisor senior que controla el informe antes de su elevación) se modelan como agentes de función acotada, cada uno con su propio conocimiento de dominio.
Este trabajo tampoco funciona como manual de usuario de una herramienta comercial, ni promete reemplazar al auditor humano. Busca sistematizar un ejercicio experimental de aplicación del framework, diseñado con datos sintéticos que reproducen las condiciones habituales de una auditoría municipal, con sus aciertos y sus fricciones, para que otros agentes de control puedan evaluar si un enfoque de este tipo podría adaptarse a sus propios procesos de control externo, y de qué manera.
3. El problema: por qué el método convencional de auditoría no escala
Antes de describir la solución conviene nombrar el problema con precisión. No es un problema de "falta de tecnología" en sentido genérico, sino de fricciones concretas que cualquier equipo de auditoría reconoce:
a) Dispersión del criterio técnico. El conocimiento sobre cómo estructurar un hallazgo, qué normativa aplica a un municipio con Carta Orgánica propia frente a uno regido por el régimen general, o cómo redactar una observación con neutralidad técnica, suele residir en la experiencia acumulada de los auditores más antiguos y transmitirse de manera oral o por imitación de informes anteriores. Esto genera heterogeneidad: dos equipos distintos, frente a la misma situación de hecho, pueden producir hallazgos con estructuras, alcances o incluso conclusiones distintas. Esta heterogeneidad se agrava cuando, ante la ausencia de una herramienta institucional propia, cada auditor recurre por su cuenta a asistentes de inteligencia artificial de uso general, sin estandarización ni trazabilidad alguna. Otros organismos de control de la región identifican este mismo patrón de adopción informal y no gobernada como un riesgo de la digitalización espontánea del sector público (Criado, 2024).
b) Costo marginal alto de las tareas repetitivas. Procedimientos como la conciliación mensualizada de cuentas bancarias, el cotejo de un libro mayor contra un extracto, o la verificación de que cada observación del informe contenga sus cuatro componentes obligatorios (condición, criterio, causa y efecto) son, en esencia, procedimientos algorítmicos. Ejecutarlos manualmente, mes a mes y cuenta a cuenta, consume horas de un profesional calificado en una tarea que no requiere, en sí misma, juicio profesional de alto nivel; ese juicio aparece después, al interpretar el resultado del cotejo, y no en el cotejo mismo. Esta distinción tiene además respaldo en el derecho administrativo, que traza una diferencia entre potestades regladas, donde la norma predetermina la conducta a seguir y por tanto es susceptible de automatización, y potestades discrecionales, donde la autoridad competente debe ponderar las circunstancias del caso concreto mediante un margen de apreciación que la propia norma le confiere (Ponce Solé, 2024). El cotejo bancario es una tarea reglada en este sentido; la interpretación de su causa y la calificación del riesgo del hallazgo no lo son. Automatizar el cotejo no automatiza el criterio: eso sigue siendo, y seguirá siendo, trabajo del auditor. Algo similar ocurre en la normativa profesional contable que rige a los auditores externos en toda la República Argentina, más allá del ámbito específico de los Tribunales de Cuentas: la Resolución Técnica N.º 37 de la FACPCE (modificada por la Resolución Técnica N.º 53) distingue, entre los procedimientos posteriores a la valoración de riesgos, pruebas de detalle y procedimientos analíticos (además de las pruebas de controles), sin pronunciarse ella misma sobre el grado de automatización de cada uno. Que estos últimos, especialmente cuando se basan en comparaciones, recálculos o cotejos sobre información estructurada, tengan un alto potencial de automatización es una lectura de este autor sobre esa distinción normativa, no una calificación que la propia norma formule; en cualquier caso, esa lectura no elimina el juicio profesional necesario para interpretar los resultados del procedimiento. Distinto es el caso de la evaluación del control interno conforme al esquema COSO III, que exige un juicio profesional sobre el diseño y la eficacia operativa de los controles del ente auditado (FACPCE, 2022).
c) Trazabilidad débil de la supervisión de calidad. Las normas de control interno de los propios organismos de control exigen verificar decenas de ítems de cumplimiento en cada informe antes de su elevación, típicamente mediante formularios de supervisión que formalizan ese control por escrito. Cuando esta verificación se realiza mediante una lectura manual del legajo completo, es fácil que un ítem quede sin control efectivo. No suele ser por negligencia, sino porque la revisión humana de una checklist extensa sobre un documento de cientos de páginas es, estadísticamente, propensa al error de omisión.
Ninguna de estas fricciones se resuelve incorporando una herramienta de inteligencia artificial "genérica" que redacte texto a pedido. Se resuelven, en cambio, codificando el criterio técnico institucional en una forma que pueda ejecutarse de manera consistente, auditar su propia ejecución, y dejar al profesional humano exactamente en el lugar donde su juicio agrega valor: la interpretación de la causa, la ponderación del riesgo y la decisión final sobre el hallazgo.
4. Marco conceptual: la auditoría entendida como un pipeline de software
La ingeniería de software resolvió, hace más de una década, un problema estructuralmente análogo al ya descripto: equipos grandes, con alta rotación, que necesitaban producir un artefacto complejo (un sistema informático) de manera consistente, verificable y con criterios de calidad estandarizados. La respuesta no fue "escribir mejor" cada vez, sino construir una arquitectura de conocimiento reutilizable. Este trabajo traslada esos conceptos al dominio de la auditoría en el sector público.
4.1. Reglas como comportamiento persistente del agente
En un pipeline de software existen configuraciones que se aplican de manera transversal a todo el sistema, sin importar la tarea puntual que se esté ejecutando. Un ejemplo típico es un estándar de seguridad que ninguna función del sistema puede violar. En el framework aquí descripto, esa función la cumple una regla de comportamiento persistente que se aplica a cualquier interacción con el agente. Define su rol (auditor especializado en el sector público), su marco normativo de referencia (la distinción, por ejemplo, entre municipios regidos por la Ley Provincial de Municipalidades y aquellos con Carta Orgánica propia, cuyo régimen legal difiere sustancialmente), su metodología de análisis de causas (evitar la especulación sin fundamento, basarse en evidencia y razonamiento deductivo) y su estilo de comunicación (objetivo, técnico, constructivo).
Esta regla cumple, en términos de gobierno de la herramienta, una función equivalente a un manual de estilo institucional obligatorio: se aplica siempre, sin excepciones, y establece los límites dentro de los cuales el agente puede operar. Uno de sus puntos, en particular, es el hallazgo metodológico más delicado de este trabajo y el objeto de la Sección 6. Se instruye expresamente al agente para que la documentación formal de auditoría (papeles de trabajo, hojas de hallazgos, observaciones) no contenga ninguna referencia a su propio proceso de generación (skills, agentes, inteligencia artificial). Así, el producto final se presenta bajo la autoría del auditor humano que lo revisó y suscribió: el framework puede escribir el borrador; la firma la pone el auditor.
4.2. Skills como procedimientos de auditoría versionables
Si la regla es el marco general, la skill es la unidad mínima de procedimiento reutilizable. Es un archivo de instrucciones que describe, con el mismo nivel de detalle que un programa de trabajo de auditoría tradicional, cuándo debe aplicarse un procedimiento determinado y cómo debe ejecutarse paso a paso. El conjunto de skills diseñado para este trabajo cuenta con más de veinticinco, organizadas por función: planificación (estructuración de bases de datos y carpetas del expediente), ejecución (consulta de bases de datos, cotejo de mayores contra extractos, criterios normativos aplicables a distintos tipos de gasto), redacción (papeles de trabajo, hojas de hallazgos, observaciones, recomendaciones, opinión de auditoría) y supervisión (memoria de supervisión, verificación de anexos, control de contestaciones del ente auditado)1.
Cada skill funciona como lo haría un procedimiento estandarizado de auditoría clásico, un programa de trabajo aprobado por los niveles superiores conforme a la normativa de control interno del organismo, con dos diferencias operativas relevantes. Primero, es ejecutable de manera consistente por cualquier miembro del equipo, sin depender de que recuerde de memoria todos los pasos ni la jurisprudencia interna acumulada. Segundo, es versionable: cuando el criterio institucional cambia (por ejemplo, se actualiza el criterio sobre gastos de terceros), la skill se corrige una vez y ese cambio se propaga automáticamente a todo el trabajo futuro del equipo, sin que cada auditor individual tenga que enterarse y actualizar su propio criterio por su cuenta.
Esta noción de skill sistematiza y extiende una línea de indagación previa del autor. Un desarrollo anterior había explorado la automatización puntual, mediante reconocimiento óptico de caracteres (OCR) y un modelo de lenguaje, del control de sumas entre las columnas "Calculado", "Modificado" y "Definitivo" de una ejecución presupuestaria en formato PDF (Villegas y Kostrencic, 2024). Aquella experiencia funcionaba como una prueba de concepto aislada, ejecutada mediante un prompt ad hoc en cada oportunidad. El aporte metodológico de este trabajo es dar el paso de esa prueba de concepto puntual a su codificación como skill persistente, versionable y reutilizable por cualquier miembro del equipo, en lugar de depender de que el mismo prompt se redacte una y otra vez.
Esta línea de indagación tiene además un antecedente propio más cercano en su enfoque, aunque distinto en su base tecnológica. Cancinos y Villegas (2025) propusieron un "Modelo de Auditoría Ágil y Segura" que persigue el mismo objetivo de fondo, dotar a los organismos de control externo (OCE) de controles automatizados, reutilizables y de bajo costo, aplicando marcos de gestión de servicios de información (DevOps, DevSecOps, ITIL 4, COBIT) sobre herramientas de Google Workspace y Python, sin recurrir a agentes de inteligencia artificial. El framework aquí descripto puede leerse como una evolución de esa misma línea de trabajo: donde aquel modelo automatizaba flujos de trabajo determinísticos (por ejemplo, la validación de un CUIT mediante un script disparado por el envío de un formulario), las skills descriptas en esta sección incorporan además la capacidad de un modelo de lenguaje para interpretar información no estructurada y redactar el papel de trabajo correspondiente, sin abandonar por eso la disciplina de versionado, reutilización y control de riesgos que ya proponía aquel trabajo previo.
4.3. Roles especializados como agentes de función acotada
El framework también modela ciertas funciones del proceso de auditoría como agentes de rol acotado: un especialista en obras públicas para el análisis de contrataciones de infraestructura, un abogado especialista para el análisis de legalidad, y un revisor senior cuya única función es controlar la calidad del informe antes de su elevación. Este último rol funciona de manera análoga a como, en un equipo de software, existe un revisor de código independiente del autor del cambio. La separación reproduce, dentro del propio proceso automatizado, el principio de las cuatro miradas (four-eyes principle), estándar habitual de control interno en auditoría, que la normativa del organismo exige mediante la separación entre quien ejecuta el trabajo de campo y quien supervisa su calidad. De hecho, un trabajo previo del autor ya proponía, para el código que automatiza controles de un OCE (consultas SQL, scripts de AppScript o Python), una política de revisión por pares antes de su puesta en producción, entendiendo esa revisión como un control por oposición y, a la vez, como una pista de auditoría sobre quién modificó la herramienta de control, cuándo y con qué propósito (Cancinos y Villegas, 2025). El mismo criterio se aplica aquí a las consultas y scripts que las skills documentan en cada papel de trabajo.
Esta separación de roles puede leerse, además, como una instancia funcional del principio general de supervisión humana que exige el artículo 14 del Reglamento (UE) 2024/1689 sobre inteligencia artificial de alto riesgo: la capacidad de comprender e interpretar los resultados del sistema, ignorarlos o revertirlos cuando corresponda, y detener el sistema ante un funcionamiento deficiente (Parlamento Europeo y Consejo de la Unión Europea, 2024). El mismo principio de supervisión humana aparece en la normativa propia del ámbito de actuación de este trabajo: el artículo 1° de la Ordenanza N.º 16537 del Concejo Deliberante de la Ciudad de Salta —cuyo ámbito de aplicación (artículo 2°) incluye expresamente al Tribunal de Cuentas Municipal— fija que la IA en la gestión pública municipal debe operar siempre como herramienta de apoyo, sin sustituir la intervención humana, y su artículo 5° agrega que en ningún caso la IA sustituirá la responsabilidad administrativa de los funcionarios (Concejo Deliberante de la Ciudad de Salta, 2026).
4.4. Arnés, orquestador y subagentes: vocabulario de la ingeniería de agentes aplicado a la auditoría
Estos conceptos (regla, skill, agente de rol acotado) se implementaron apoyándose en la infraestructura y el vocabulario técnico que la propia industria de plataformas de agentes de inteligencia artificial estandarizó hacia comienzos de 2026 (Anthropic, 2026; Google, 2026). Esta sección introduce dos términos adicionales de esa misma fuente, arnés y orquestador, necesarios para describir con precisión cómo operan por debajo del nivel conversacional la Regla y los agentes de rol acotado.
Corresponde una salvedad metodológica antes de avanzar. Lo que sigue sobre el funcionamiento interno de arneses, orquestadores y subagentes se apoya en documentación técnica que los propios proveedores (Anthropic, Google) publican sobre sus plataformas, no en una auditoría de código independiente realizada por el autor: ni Anthropic ni Google publican el código fuente que permitiría verificar de manera directa cómo se ejecutan estos mecanismos por dentro. Se los cita aquí, en consecuencia, como la descripción pública más autorizada disponible de ese diseño, con la reserva de que se trata de la caracterización que el propio proveedor hace de su producto y no de un hallazgo verificado por un tercero.
El primero es el arnés (harness), término que Anthropic (2026) define como toda la infraestructura que rodea a un modelo de lenguaje y lo convierte en agente: el registro de herramientas disponibles, la gestión del contexto, la memoria entre sesiones, el manejo de errores, los límites de seguridad (guardrails) y el bucle de retroalimentación que le permite ejecutar acciones sucesivas hacia un objetivo. La fórmula que resume el concepto, agente es igual a modelo más arnés, permite precisar algo que ya se daba por sentado sin nombrarlo: la Regla no es una propiedad del modelo de lenguaje subyacente, que podría reemplazarse mañana por otro, sino una configuración del arnés que lo aloja, y por eso persiste con independencia de qué modelo se use en cada momento. "Ingeniería de arnés" (harness engineering) es, de hecho, el término que Anthropic (2026) propone como disciplina distinta de la ya más conocida "ingeniería de prompt", y es la fuente directa de la que se toma aquí la distinción entre configuración del arnés y modelo subyacente.
Sobre ese arnés se apoyan, además, un agente orquestador y los subagentes ya descriptos. El orquestador recibe el objetivo de alto nivel que plantea el auditor, por ejemplo, revisar la legalidad de una contratación de obra pública y su impacto presupuestario, y lo descompone en subtareas, cada una asignada a un subagente de función acotada: el especialista en obras públicas, el abogado especialista, el revisor senior ya presentados. La documentación técnica de Google (2026) describe esta separación en los mismos términos que se aplican aquí: aislar cada subtarea en una ventana de contexto propia reduce el consumo de recursos de cómputo, evita que instrucciones en competencia disparen alucinaciones, y ayuda a que las modificaciones se hagan exactamente donde se pretende. El Esquema 1 ilustra este flujo.
Esquema 1. Agente orquestador y subagentes de función acotada
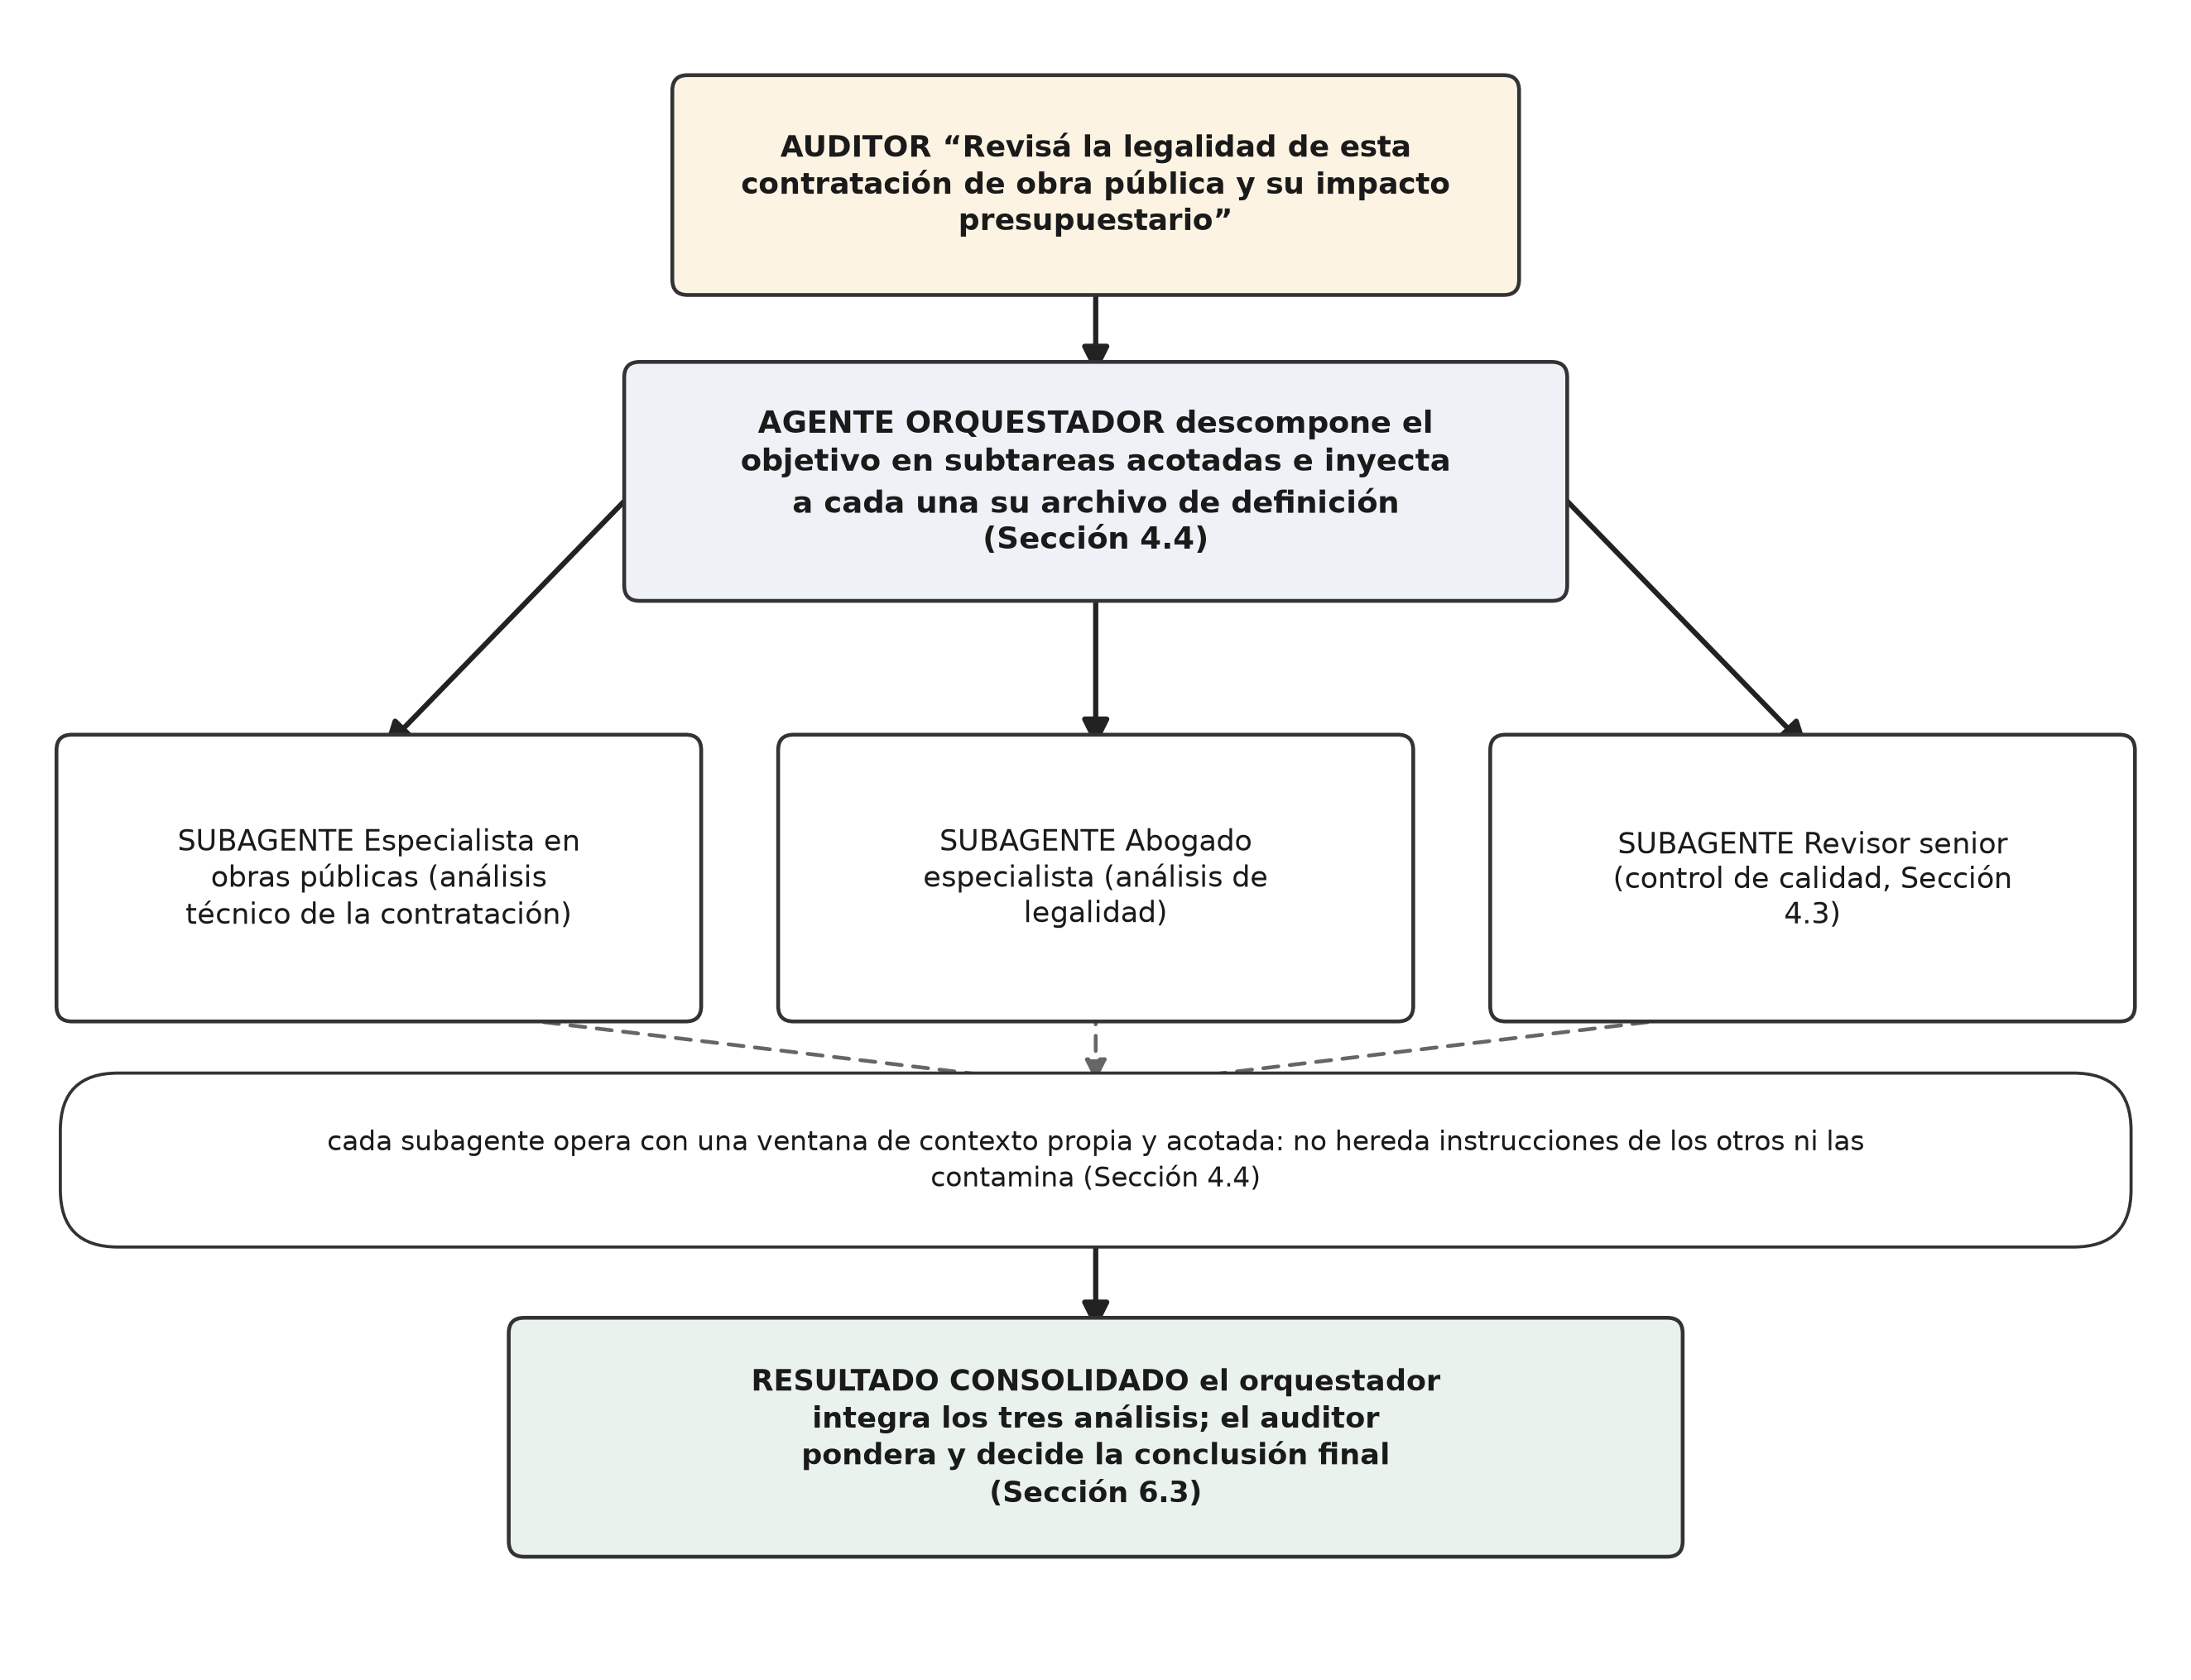
La misma documentación de Google (2026) describe, además, un mecanismo que ayuda a entender por qué una skill no "improvisa" al ejecutarse: el orquestador inyecta el contenido literal del archivo de definición del subagente o la skill en el prompt de ejecución, en lugar de dejar que el sistema genere sus propias instrucciones en el momento. Es la contraparte técnica de la afirmación de que una skill "es versionable": lo que queda guardado en el control de versiones es el mismo archivo de texto que se inyecta sin alteración en cada ejecución.
La Tabla 1 reúne, a modo de glosario, los términos técnicos en inglés empleados en este trabajo y su significado, tal como los define la fuente citada en cada caso.
Tabla 1. Glosario de términos en inglés utilizados en este trabajo
| Término | Significado |
|---|---|
| Framework | Marco de trabajo: la arquitectura de reglas, skills y agentes que estructura el proceso de auditoría descripto en este trabajo. |
| Prompt | Instrucción en lenguaje natural que el auditor le da al agente para que ejecute una tarea puntual. |
| Infrastructure as code / Audit as code | Tratar la infraestructura (o, en este trabajo, el propio proceso de auditoría) como si fuera código de software: versionado, reutilizable y sometido a revisión, en lugar de configurado manualmente cada vez. |
| Regla | Comportamiento persistente que se aplica a toda interacción del agente, con independencia de la tarea puntual. |
| Skill | Procedimiento de auditoría reutilizable, versionable e invocable, equivalente a un programa de trabajo estandarizado. |
| Agente de rol acotado | Agente especializado en una función específica del proceso de auditoría, con su propio conocimiento de dominio. |
| Four-eyes principle | Principio de las cuatro miradas: exige que quien ejecuta una tarea y quien la supervisa sean personas distintas, como forma de control por oposición. |
| Arnés (harness) | Infraestructura que rodea a un modelo de lenguaje y lo convierte en agente: registro de herramientas, gestión de contexto, memoria entre sesiones, manejo de errores y guardrails (Anthropic, 2026). |
| Guardrails | Límites de seguridad configurados en el arnés que acotan lo que el agente puede hacer (Anthropic, 2026). |
| Harness engineering | Disciplina de diseño del arnés que aloja a un agente, distinta de la ya más conocida "ingeniería de prompt" (Anthropic, 2026). |
| Agente orquestador | Agente que recibe el objetivo de alto nivel planteado por el auditor y lo descompone en subtareas asignadas a subagentes (Google, 2026). |
| Subagente | Agente que ejecuta una subtarea acotada dentro de su propia ventana de contexto, sin instrucciones ajenas a su función (Google, 2026). |
| Context engineering | Ingeniería de contexto: disciplina que organiza toda la información disponible para un agente al momento de responder. |
| On-premise | Modelo de lenguaje ejecutado en servidores propios del organismo, sin conexión a servicios de terceros en la nube. |
| Automation bias | Sesgo de automatización: confianza excesiva en un resultado por el solo hecho de haber sido generado por un sistema automatizado. |
| Isolation Forest | Algoritmo de aprendizaje automático para detectar anomalías o valores atípicos en grandes volúmenes de datos. |
| Chief Artificial Intelligence Officer | Responsable institucional de la gobernanza de inteligencia artificial dentro de un organismo. |
5. Estudio de caso metodológico: LA MUNICIPALIDAD
5.1. El escenario
A los fines de ilustrar la aplicación práctica del framework, se presenta un caso ficticio e ilustrativo: la auditoría de la Cuenta General del ejercicio de un municipio ficticio, en adelante, lo llamaremos "LA MUNICIPALIDAD". El caso fue diseñado como un ejercicio experimental: los datos, montos, cuentas bancarias, hallazgos, son sintéticos, construidos para reproducir con realismo las condiciones habituales de una auditoría municipal (estructura de cuentas, tipos de desvíos, volumen de observaciones), sin corresponder a la información de ningún expediente real, en trámite o finalizado.
Conviene precisar aquí de qué tipo de evidencia se dispone y de qué tipo no. La sistematización que sigue no proviene de una bitácora de investigación diseñada de antemano con esa finalidad, sino de dos fuentes producidas durante el desarrollo del propio framework y reconstruidas después con fines expositivos: el historial de control de versiones, que registra de manera objetiva qué skills y reglas cambiaron, cuándo y por qué motivo declarado; y la experiencia profesional del autor y su equipo en auditoría municipal, a partir de la cual se reconstruyeron, en clave hipotética y sin identificar a ningún ente ni expediente, los intercambios de diálogo que aparecen en esta sección. Esa base documenta con razonable solidez qué se construyó y cuándo cambió; no permite, en cambio, sostener afirmaciones sobre magnitud de ahorro de tiempo, tasas de error o cualquier otra medición cuantitativa, porque el ejercicio no incluyó un registro comparativo de horas insumidas antes y después del framework. Esa limitación se retoma más adelante y es, de hecho, el motivo de una de las recomendaciones finales de este trabajo.
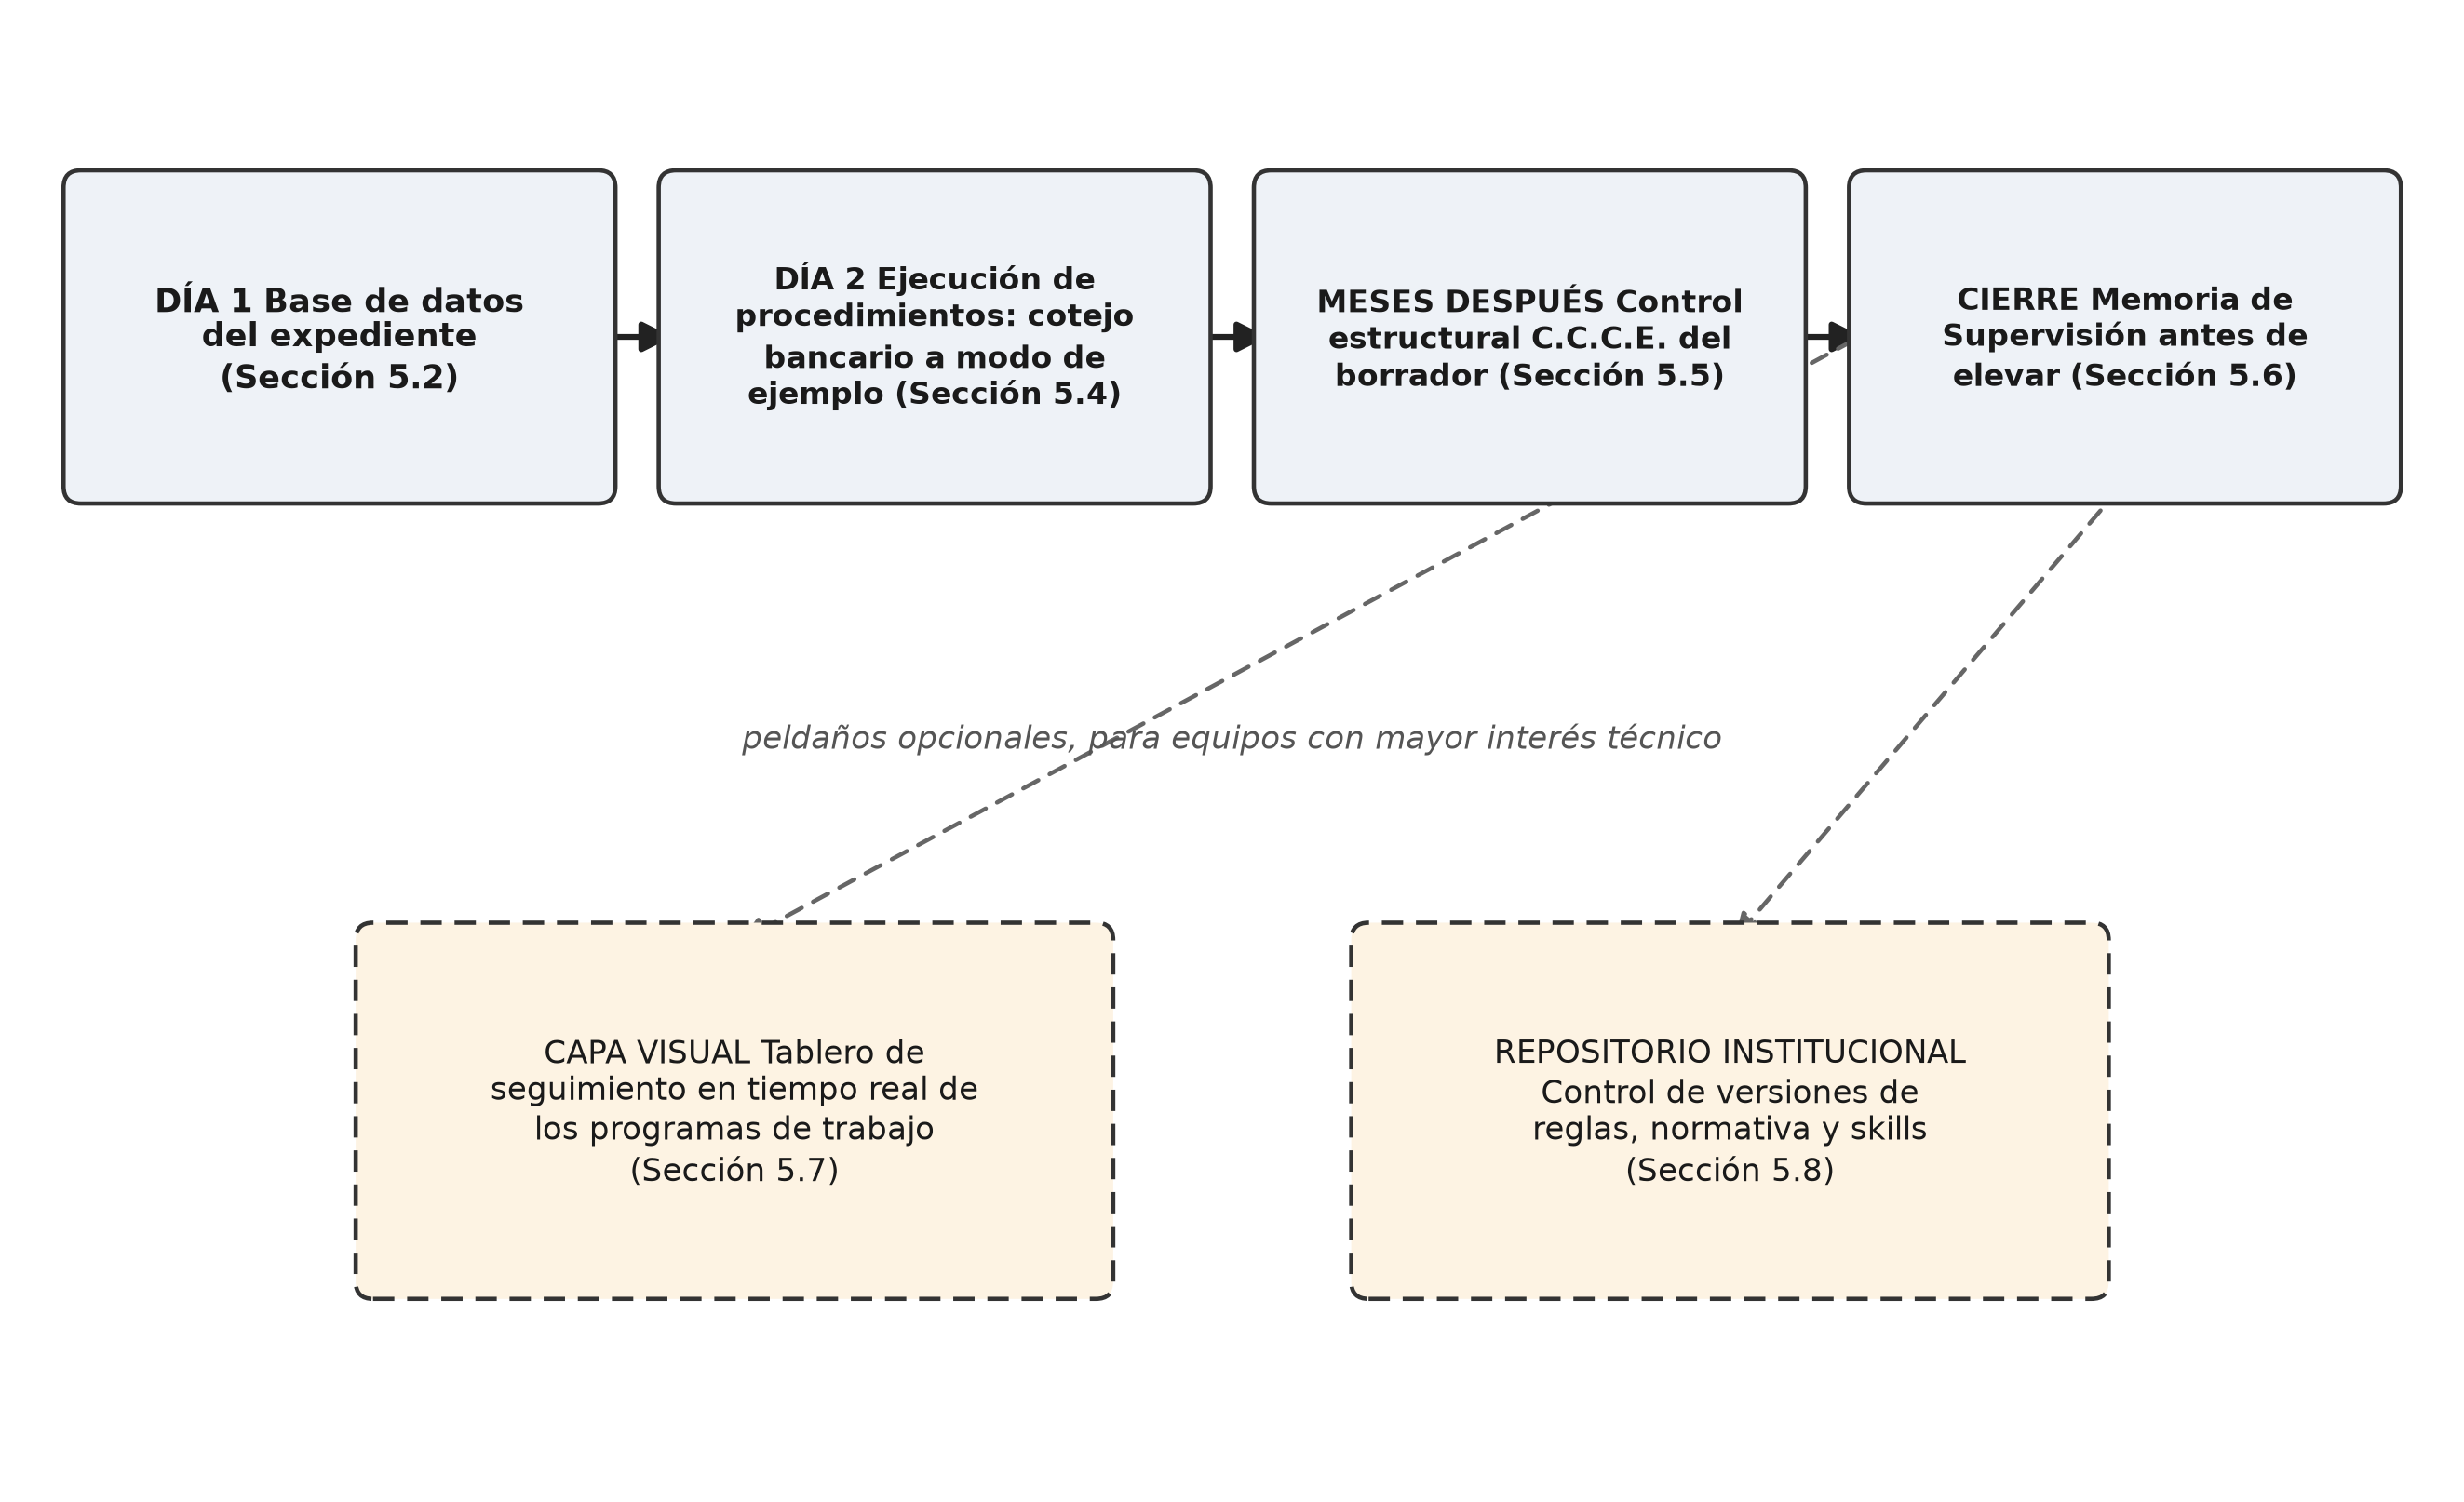
El framework no se presenta acá como un catálogo de funcionalidades. Se recorre en el mismo orden en que un equipo lo atraviesa en la práctica: desde el primer día de campo, cuando el expediente es apenas unos pdfs y una pila de excels, hasta el cierre, cuando ese mismo expediente tiene que elevarse con la calidad verificada. Ese recorrido cronológico organiza el resto de esta sección, y el Esquema 2 lo resume como mapa de ruta antes de recorrerlo en detalle.
Esquema 2. Mapa de ruta cronológico del caso
Algunas de las bisagras metodológicas más significativas de ese recorrido, la carga y estructuración del expediente, el cotejo bancario, el cierre por supervisión, se ilustran con un diálogo hipotético entre colegas, construido a partir de la experiencia profesional del autor en auditoría municipal y no como transcripción de un intercambio real. Sirve para mostrar, en el lenguaje llano de la sala de auditoría, dónde decide el criterio humano y dónde un procedimiento sistemático puede hacerse cargo del resto.
5.2. Sentar las bases (la base de datos del expediente)
El primer día de campo en LA MUNICIPALIDAD no empieza con un hallazgo. Empieza con una pila de archivos Excel (mayores contables, extractos bancarios, planillas de liquidación de haberes) que el ente auditado entregó tal como los produce su propio sistema. La primera decisión metodológica, antes de analizar una sola cifra, es qué hacer con ese volumen de información para que sea manejable durante los meses siguientes de auditoría.
—El asistente me consume una barbaridad de contexto. Le subo el Excel de mayores contables completo, con los doce meses, y a la tercera pregunta ya me dice que se quedó sin espacio para seguir.
—Es esperable: cada fila del archivo se convierte en texto que el modelo tiene que "leer" entero cada vez, aunque tu pregunta sea sobre un solo mes. Por eso conviene pasar el Excel a CSV y cargarlo en una base de datos liviana. Ahí no le mostrás los datos al modelo: le pedís una consulta SQL puntual, y el motor de la base hace el trabajo pesado. Al modelo solo le llega el resultado, doce números, no diez mil filas. Es el mismo paso extra que ya hacíamos a mano al armar una tabla dinámica en vez de mirar la base cruda; la diferencia es que esa base, una vez cargada, sirve para todas las preguntas del expediente, no solo para una.
La conversación resume, en el lenguaje llano de dos colegas, la misma decisión de arquitectura: los datos voluminosos del expediente no deben "mostrársele" al agente en bruto, sino cargarse una vez en una base de datos consultable, de modo que cada pregunta se resuelva con una consulta acotada y no con la relectura del archivo completo. Es lo que hace viable trabajar con expedientes de miles de fojas sin que el procesamiento se degrade a medida que crecen. Esta carga inicial, además, no requiere de un desarrollador externo: el propio agente puede ejecutarla, reduciendo el riesgo de error asociado a copiar y pegar planillas2.
Ese paso de carga es, además, la ejecución de un procedimiento de auditoría tradicional: antes de aceptar como válida la información volcada a la base, corresponde verificar su fidelidad respecto de la fuente cruda mediante controles de sumas horizontales y verticales y otras pruebas de cuadratura clásicas de cualquier auditoría financiera. La diferencia con el método convencional es que estas pruebas se ejecutan una sola vez, de manera sistemática, al construir la base, y no cada vez que alguien necesita confiar en una cifra. No es infrecuente, además, que aparezcan errores aritméticos en la información que presenta el ente auditado; el propio proceso de construcción de la base puede así dar origen a observaciones para el informe.
5.3. ¿Cómo sabe la IA qué normativa aplica?: reglas, metadatos y organización de carpetas
Con la base de datos ya construida, surge una segunda pregunta, anterior incluso a cualquier hallazgo: ¿cómo sabe el agente qué normativa rige a este municipio en particular, o dónde están los datos básicos del expediente, sin que alguien se lo tenga que explicar de nuevo cada vez que se abre una conversación nueva? La respuesta no está en la conversación misma, sino en capas separadas, de distinta persistencia y alcance. Que LA MUNICIPALIDAD tenga Carta Orgánica propia y no el régimen general de municipalidades se deja escrito una sola vez en un archivo de reglas que se carga siempre, en cada sesión, sin que nadie tenga que repetirlo. Los datos del expediente en sí (número, autoridades, rutas de carpetas) viven en una segunda ficha de metadatos, fuente única de verdad. Y la normativa completa no se pega ahí adentro: vive aparte, ordenada en su propia carpeta, un archivo por norma; cuando hace falta citar una ley o una resolución, el agente busca el archivo puntual y cita la ruta exacta al pie del hallazgo, y si la norma que necesita no está cargada, debe decir que no la encontró, no inventarla.
Esta separación tiene, en la disciplina que estudia el diseño de agentes de inteligencia artificial, un nombre técnico: ingeniería de contexto (context engineering), la disciplina que organiza toda la información que un agente tiene disponible al momento de responder. El Esquema 3 representa esa jerarquía tal como se aplicó en este framework, ordenada de la capa más estable y general (la que casi nunca cambia) a la más efímera y puntual (la que cambia en cada interacción):
Esquema 3. Jerarquía de capas de la ingeniería de contexto aplicada a la auditoría
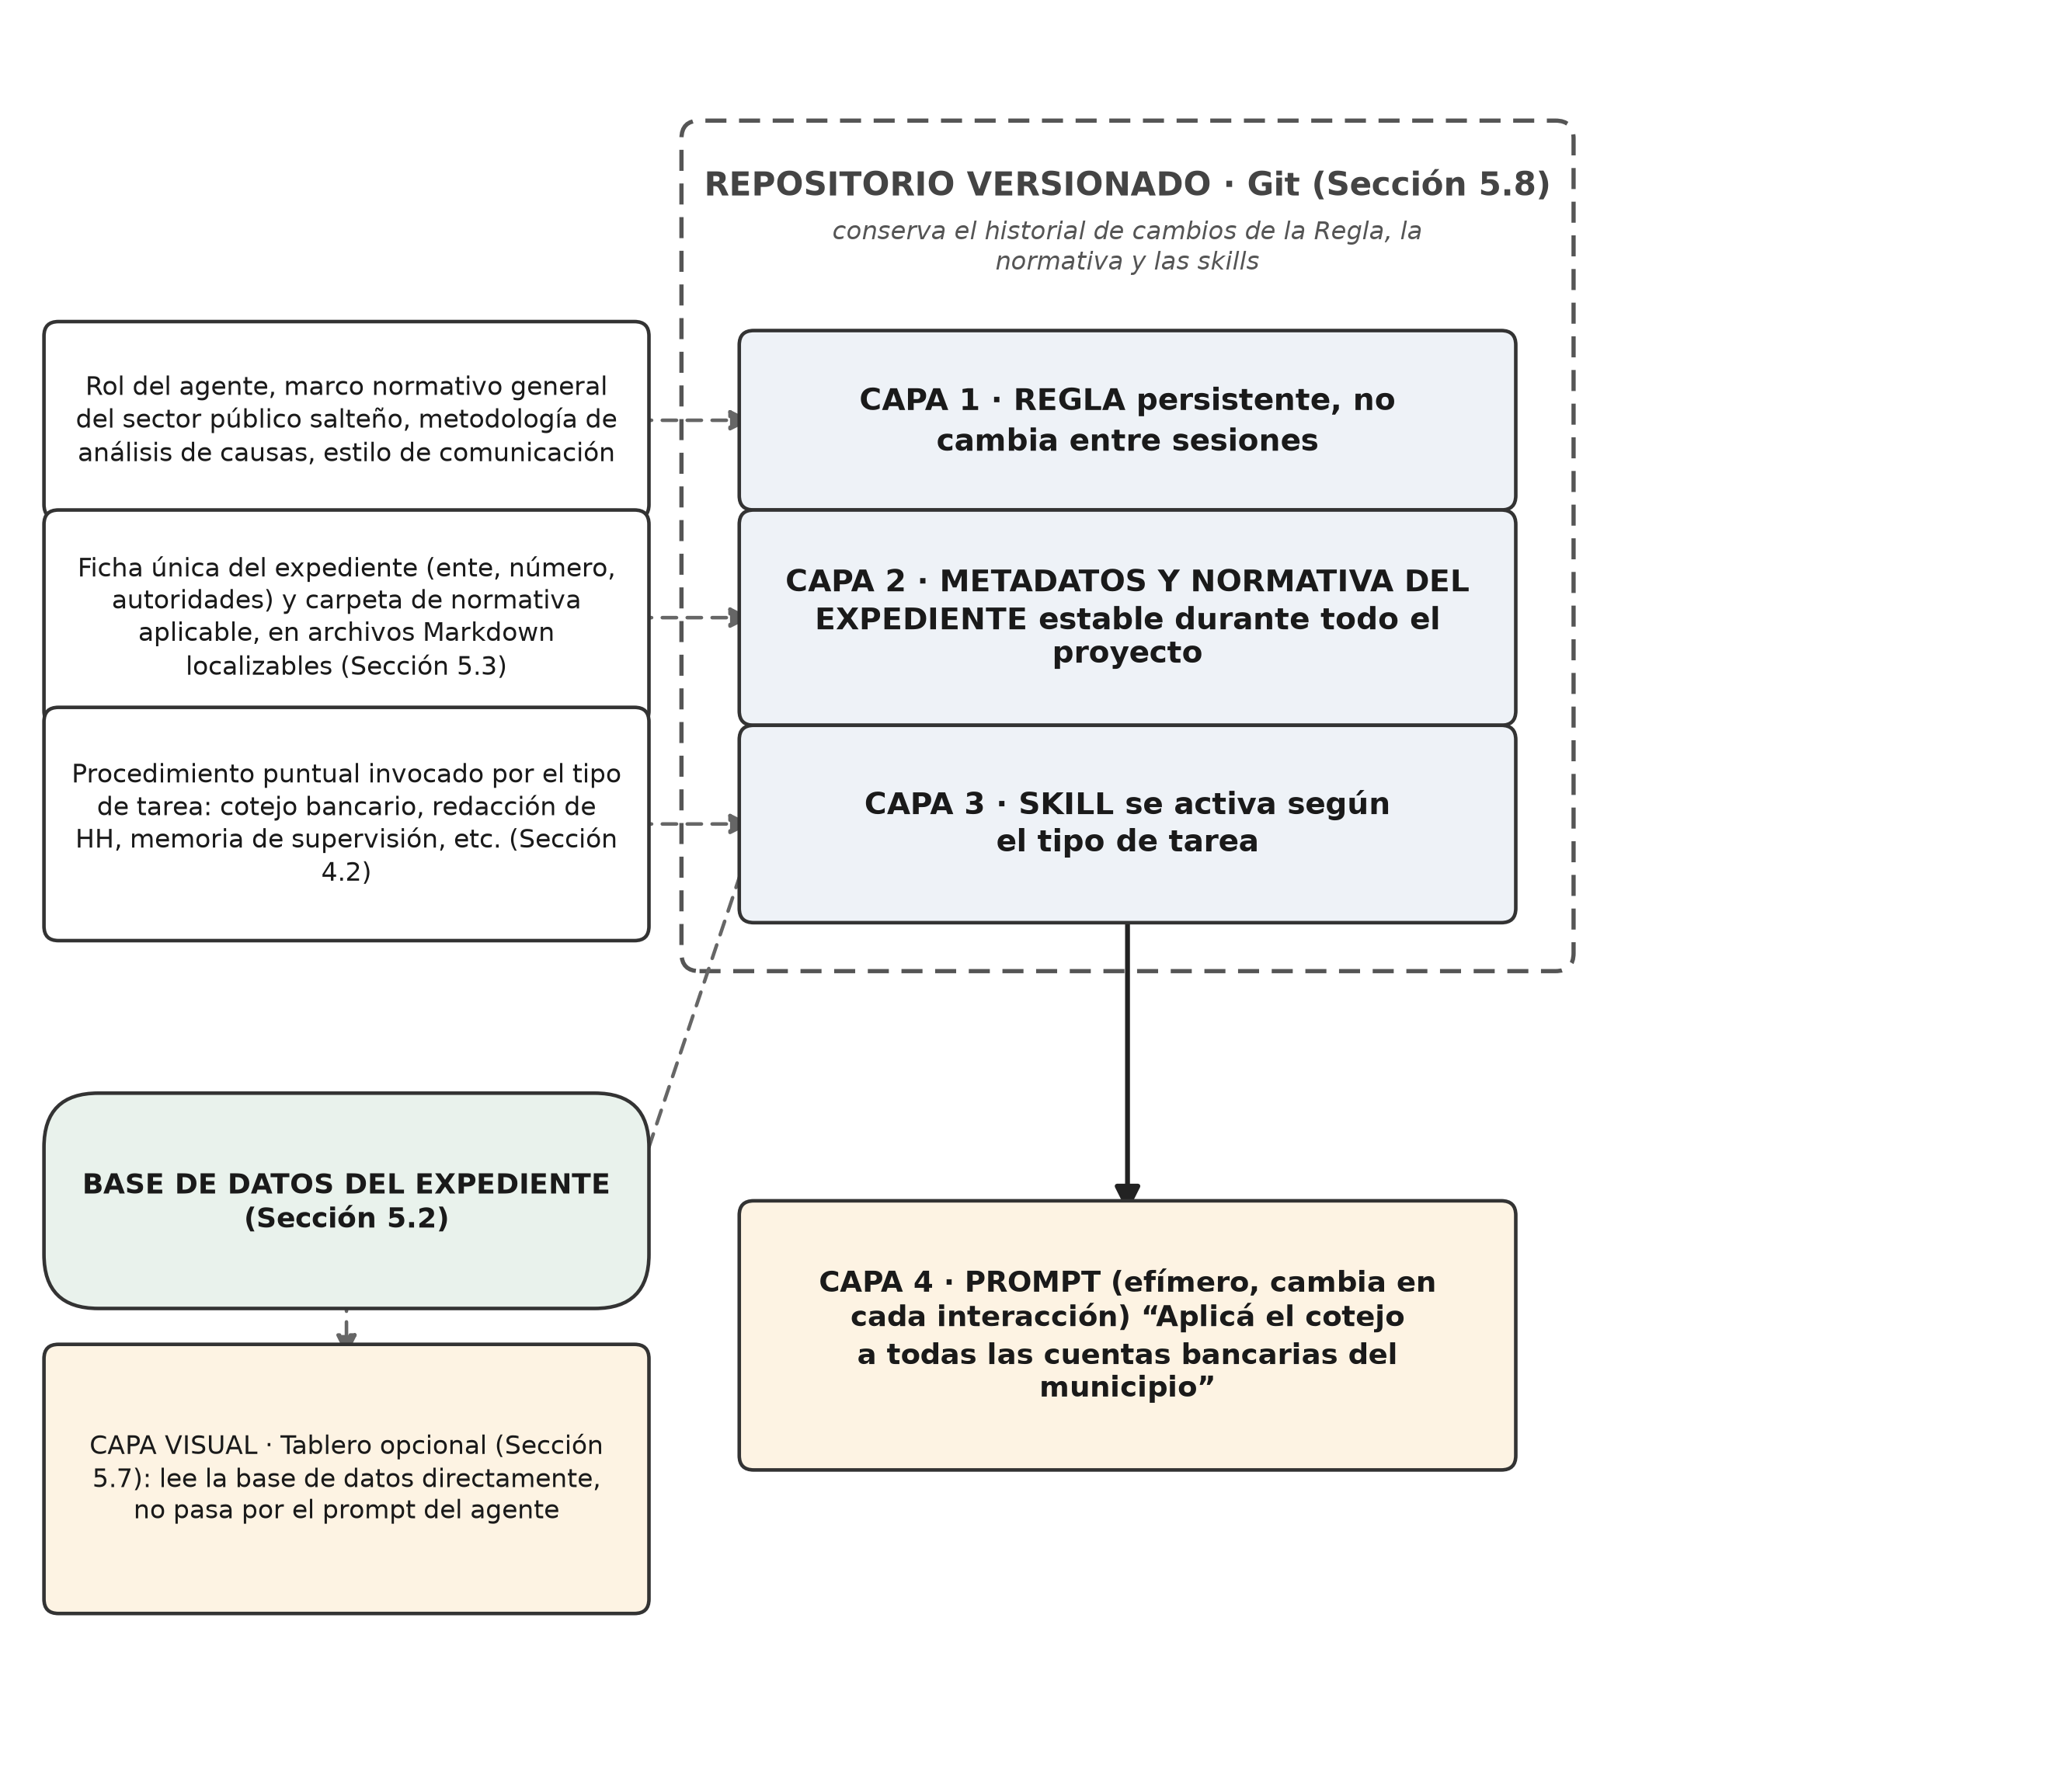
Leído de arriba hacia abajo, el esquema muestra que cada capa acota a la siguiente. La Regla (Capa 1) es el marco dentro del cual operan los metadatos y la normativa del expediente (Capa 2). Estos, a su vez, son el terreno sobre el que se activa una skill puntual (Capa 3). Y la skill, finalmente, interpreta y ejecuta el prompt concreto del auditor (Capa 4). Ninguna capa superior puede contradecir a una capa anterior: un prompt no puede pedirle al agente que ignore la Regla, del mismo modo en que una consulta SQL puntual no puede alterar la estructura de la base de datos que la contiene. Esta jerarquía, más que la sofisticación del modelo de lenguaje subyacente, explica por qué el framework produce resultados consistentes entre distintos auditores y distintos expedientes: las capas más estables, Regla, metadatos y skills, ya están fijadas de antemano, sin depender de que cada persona recuerde escribir un buen prompt.
El esquema permite además precisar dos cuestiones que no son evidentes a simple vista. Primero, las capas persistentes, Regla, metadatos y normativa, skills, no viven sueltas en el disco del auditor: están contenidas en un repositorio versionado, que es lo que efectivamente sostiene la afirmación de que una skill "es versionable". Segundo, la base de datos del expediente tiene dos consumidores distintos y no debe confundirse uno con otro. Las skills la consultan mediante SQL para responder al prompt puntual del auditor (Capa 3 → Capa 4), pero la capa visual opcional la lee de manera directa, sin pasar en ningún momento por el agente ni por su ventana de contexto: es un camino paralelo, útil para obtener una vista permanente del expediente, y no otra capa de la jerarquía conversacional.
Un agente de inteligencia artificial, sin embargo, no "sabe" derecho administrativo salteño de la misma manera en que lo sabría un abogado con años de trayectoria. Sabe leer y citar con precisión los documentos que se le pusieron a disposición, organizados en un formato de texto simple (Markdown, en la implementación de este trabajo) que es a la vez legible por una persona y fácilmente localizable por el agente. La arquitectura de carpetas del expediente, la separación entre normativa provincial y normativa propia de cada ente, y la existencia de un archivo único de metadatos son la condición de posibilidad para que el agente cite con exactitud en lugar de inventar con soltura; no son un simple detalle de organización administrativa.
5.4. La ejecución de los procedimientos de auditoría (el cotejo bancario, a modo de ejemplo)
Con la base de datos construida y el agente orientado sobre la normativa aplicable desde el día uno, el trabajo de campo avanza a un ritmo que el método convencional no permite. Al segundo día ya es posible ejecutar sobre la totalidad del expediente, y no cuenta por cuenta ni partida por partida a lo largo de varias semanas, cualquiera de los procedimientos sustantivos habituales de una auditoría financiera (cotejos, recálculos, verificaciones de existencia, análisis de razonabilidad). Esta sección desarrolla uno de ellos, el cotejo bancario, a título ilustrativo; el mismo principio de ejecución sistemática sobre la base de datos del expediente se aplica al resto.
El cotejo entre los libros mayores y los extractos bancarios es, además, uno de los procedimientos que tradicionalmente más horas consume del equipo auditor. Implica revisar mes a mes y cuenta por cuenta la totalidad de los movimientos bancarios del ejercicio, y por eso mismo es uno de los que mejor ilustra dónde se concentra la ganancia de tiempo del enfoque propuesto.
El disparador. El auditor no ejecuta el cotejo a mano: le indica al agente, en una única instrucción, que aplique el procedimiento de cotejo sobre la totalidad de las cuentas bancarias del municipio. Esa instrucción activa la skill correspondiente, que interroga la base de datos del expediente, agrupa mensualmente los movimientos de cada cuenta y produce, como primer entregable, una Hoja Llave con la matriz resumen de todas las cuentas bancarias operadas por el municipio.
Tabla 2. Hoja Llave — Cotejo de Mayores Contables vs. Extractos Bancarios (extracto ilustrativo)
| Cuenta Bancaria | Cuenta Mayor | Ingresos s/ Mayor ($) | Acreditaciones s/ Extracto ($) | Diferencia Neta No Explicada ($) | Ref. PT Específico |
|---|---|---|---|---|---|
| Cta. 210044103587221 | Coparticipación Provincial | 1.850.400.220,00 | 1.853.817.820,00 | 3.417.600,00 | PT Coparticipación |
| Cta. 210044109871004 | Recaudación Propia | 410.300.550,00 | 410.580.112,00 | 279.562,00 | PT Recaudación |
| Cta. 210044117723390 | Fiesta Patronal | 92.450.700,00 | 92.450.700,00 | 0,00 | — |
| Cta. 210044120045118 | Programas Sociales | 8.120.400,00 | 8.120.400,00 | 0,00 | — |
| Cta. 210044125390027 | Convenio Vivienda | 1.062.125,00 | 1.062.125,00 | 0,00 | — |
| TOTALES | 2.362.333.995,00 | 2.366.031.157,00 | 3.697.162,00 |
(Cifras íntegramente ficticias, construidas para este trabajo; no corresponden a datos reales de ningún expediente en trámite.)
La Hoja Llave se genera en minutos, para la totalidad de las cuentas del municipio y no para una sola. Con ella a la vista, el auditor identifica que la diferencia más significativa se concentra en la cuenta de Coparticipación Provincial, y le pide al agente que profundice puntualmente sobre esa partida.
—La skill me dejó un montón de consultas SQL metidas en el papel de trabajo, con nombre de tabla y todo. ¿No alcanza con dejar solo la conclusión?
—No. Al informe no va tal cual, va al Papel de Trabajo, que es un documento distinto del informe final, y esas consultas no están de adorno: son la trazabilidad de cómo se llegó a la cifra. Si algún día alguien la cuestiona, un revisor, el propio ente en su descargo, un tribunal, con la conclusión sola no tenés cómo defenderla; con la consulta documentada, reproducís el cálculo en el momento. Es como dejar visibles las fórmulas de una planilla en vez de pegar solo el número final.
Extracto del Papel de Trabajo — consultas aplicadas (ejemplo ilustrativo). A continuación, un extracto simplificado de las consultas que el agente documenta dentro del propio Papel de Trabajo al profundizar sobre la partida de Coparticipación Provincial:
-- Ingresos según Mayor Contable, cuenta Coparticipación, mes de agosto
SELECT Fecha, Debe, Detalle
FROM MayoresCtasPatr
WHERE cod_cuenta = 111210200
  AND SUBSTR(Fecha, 4, 2) = '08';

-- Acreditaciones según Extracto Bancario, misma cuenta y mes
SELECT fecha, importe, concepto_transaccion
FROM BancoMacro
WHERE cuenta = 210044103587221
  AND debito_credito = 'C'
  AND SUBSTR(fecha, 4, 2) = '08';
Para quien no proviene de un entorno de programación, estas dos consultas pueden parecer un lenguaje ajeno a la profesión contable. No lo son: cada cláusula reproduce, palabra por palabra, una acción manual que cualquier auditor que trabajó con planillas de cálculo ejecuta desde hace años. SELECT elige qué columnas mostrar, equivalente a dejar visibles u ocultar columnas de la planilla; FROM indica en qué tabla buscar, equivalente a abrir la pestaña donde está el Libro Mayor; cada cláusula WHERE/AND filtra las filas que cumplen una condición, equivalente a aplicar Filtro por cuenta o por un rango de fecha; y el agrupamiento y suma del paso siguiente equivale a armar una Tabla Dinámica. No hay ninguna operación en la consulta que un auditor no supiera hacer a mano con Excel. La diferencia es que se escribe una vez, se ejecuta en segundos sobre la totalidad del expediente, y queda documentada palabra por palabra en el Papel de Trabajo como evidencia reproducible, a diferencia de un clic sobre un menú de filtros, que no deja rastro.
Procedimiento sistematizado. Sobre la partida de Coparticipación, la skill de cotejo aplica el mismo procedimiento descripto anteriormente (agrupamiento mensual, contraste de la hipótesis de anulación bancaria, documentación de la omisión), ahora a nivel transaccional. El resultado es un papel de trabajo específico que desagrega la diferencia anual mes a mes:
Tabla 3. Comparativa mensual — Cuenta Coparticipación Provincial (extracto ilustrativo)
| Mes | Ingresos s/ Mayor ($) | Acreditaciones s/ Extracto ($) | Diferencia ($) |
|---|---|---|---|
| Junio | 154.200.100,00 | 154.200.100,00 | 0,00 |
| Julio | 148.960.300,00 | 148.960.300,00 | 0,00 |
| Agosto | 150.200.000,00 | 153.617.600,00 | 3.417.600,00 |
| Septiembre | 161.330.400,00 | 161.330.400,00 | 0,00 |
| TOTAL ANUAL | 1.850.400.220,00 | 1.853.817.820,00 | 3.417.600,00 |
(Meses no listados arrojaron diferencia $0. Cifras ficticias.)
La skill aísla así el mes de agosto como el único período con desfasaje. Sobre ese mes ejecuta el descarte de la hipótesis de anulación bancaria: busca, en el universo completo de cuentas y en ambas direcciones (débito y crédito), algún movimiento espejo por $3.417.600 que explique la diferencia como una reversión bancaria neutra. No lo encuentra. Concluye entonces que se trata de una acreditación real, una transferencia de coparticipación provincial que ingresó efectivamente a la cuenta bancaria en agosto y que el Libro Mayor municipal nunca registró, ni ese mes ni ningún otro.
Resultado del caso. El hallazgo se documenta siguiendo la estructura obligatoria de Condición-Criterio-Causa-Efecto, con la sección específica de "Descarte de Hipótesis de Anulación Bancaria" que exige el procedimiento, permitiendo fundamentar de manera taxativa la conclusión: una omisión de registración de $3.417.600 en la cuenta de Coparticipación Provincial correspondiente a agosto del ejercicio bajo examen.
Valor agregado del enfoque. El procedimiento que ejecuta el agente es, en esencia, el mismo que aplicaría manualmente un auditor humano; lo relevante de este caso no es que el agente haya "encontrado" el hallazgo por sí solo, sino la velocidad y la documentación sistemática con que quedó resuelto el descarte de hipótesis alternativas. Esto libera al equipo auditor para profundizar en el análisis de causa (¿por qué no se registró la transferencia? ¿existe una debilidad de control interno en el circuito de conciliaciones bancarias del municipio?), en lugar de agotar en la mecánica repetitiva del cotejo cuenta por cuenta el tiempo que, en la práctica tradicional, más horas insume del equipo auditor.
5.5. Antes de presentar el informe: el control estructural del hallazgo (C.C.C.E.)
Meses después, con el trabajo de campo ya avanzado y el borrador del Informe de Auditoría con varias decenas de observaciones redactadas, la preocupación cambia de naturaleza. Ya no se trata de encontrar el desvío, sino de asegurarse de que todo lo ya escrito esté completo y sea consistente antes de que lo vea la Gerencia. Con cuarenta y tres observaciones acumuladas en el borrador, releer las trescientas páginas del informe para verificar que a ninguna le falte la Causa o el Efecto dejó de ser una opción razonable. En su lugar, el equipo corre primero el control estructural, que devuelve una tabla con las cuarenta y tres observaciones marcando, para cada una, si tiene los cuatro componentes o si le falta alguno, y si se coló algún término no neutral como "irregular". Ese control es un punto de partida, no el final: las observaciones marcadas como incompletas se revisan con más atención, y las que vinieron bien reciben una pasada más liviana, de modo que la atención del equipo se concentra donde hace falta en lugar de repartirse por igual entre las cuarenta y tres.
Las normas de auditoría externa aplicables exigen que toda observación del informe definitivo contenga cuatro componentes: Condición (qué se encontró), Criterio (qué norma o estándar se vulnera), Causa (por qué ocurrió) y Efecto (qué consecuencia tiene, con calificación de riesgo). En un informe de auditoría municipal extenso, con decenas de observaciones distribuidas en distintos capítulos, verificar manualmente que cada una contenga sus cuatro componentes, y que ninguna incorpore adjetivos calificativos que comprometan la neutralidad técnica exigida, como el término "irregular", es una tarea de revisión textual sistemática, no de juicio profesional.
El framework aborda este control mediante un script de verificación sintáctica que escanea el borrador del informe y produce automáticamente una tabla de cumplimiento por observación (componente presente / ausente), además de señalar la presencia de terminología no neutral y la ausencia de notas aclaratorias obligatorias en cuadros transcriptos de fuentes externas. El resultado no reemplaza la revisión del supervisor, la convierte en una revisión dirigida: el tiempo profesional se concentra en las observaciones que el control automatizado señaló como incompletas, en lugar de releerse el informe completo en busca de omisiones que un control sistemático detecta con mayor confiabilidad.
5.6. El cierre del expediente: la memoria de supervisión
Llega, finalmente, el cierre. El borrador del informe está redactado, corregido y con sus observaciones estructuradas; lo que falta es el último control antes de que el expediente salga de la mesa del equipo de campo hacia la Gerencia General y el Auditor General del área.
—Para elevar el Proyecto de Informe de Auditoría Definitivo (PIAD) me faltan los veintinueve ítems de los tres Formularios de Supervisión. Entre el legajo físico y el borrador son miles de fojas para chequear una por una.
—Generá primero la Memoria de Supervisión: recorre el borrador y la carpeta del expediente y te devuelve, ítem por ítem, si está cumplido, si falta algo o si no aplica. No reemplaza tu firma como supervisor ni es una autorización para elevar directo; es un insumo que te ahorra empezar de cero, cuadro por cuadro, y te da evidencia sistemática de los veintinueve ítems en vez de la sensación de "creo que está todo".
Este último tramo del recorrido es, quizás, el más significativo desde el punto de vista de la gobernanza del framework. La supervisión de calidad del expediente se somete, a su vez, a un procedimiento estructurado que produce una Memoria de Supervisión, documentando el estado de cumplimiento de cada uno de los ítems exigidos por la normativa de control interno del organismo (en el caso ilustrado, veintinueve ítems repartidos en los formularios de supervisión reglamentarios), con un veredicto expreso, aprobado o con desvío detectado, por cada control, y una conclusión final sobre si el expediente está en condiciones de elevarse.
La diferencia decisiva es que la conclusión sobre si el expediente puede elevarse no la determina el script. Un script puede avisar que falta un ítem; no puede decidir si el expediente está listo. El resultado del control es un insumo que el supervisor humano, el Gerente General del área, pondera y sobre el cual decide, conservando la responsabilidad profesional indelegable que le asigna la normativa institucional.
5.7. Un peldaño más: la capa de gestión visual para equipos avanzados
Todo lo relatado hasta acá (la base de datos del expediente, las reglas, las skills, la memoria de supervisión) se opera enteramente por conversación. El auditor le pide algo al agente en lenguaje corriente y recibe un documento, una tabla o un archivo Markdown como respuesta. Ningún miembro del equipo necesita escribir una línea de código para aprovechar ese primer nivel. Hacia el final del ejercicio, sin embargo, cuando el expediente de LA MUNICIPALIDAD ya tenía ocho programas de trabajo corriendo en paralelo, apareció una necesidad distinta. Ya no alcanzaba con preguntarle al agente "¿cómo viene el programa de Deudas?" cada vez, sobre todo cuando el resumen que la Gerencia recibía un día no coincidía con el del día anterior. Hacía falta poder mirarlo de un vistazo, sin preguntar nada, con un tablero que se actualizara solo, leyendo directamente la base de datos del expediente y mostrando el estado de los ocho programas en tiempo real. Esa conversación describe, en los mismos términos con que se explica el resto del framework a un auditor sin formación técnica, el paso que separa el nivel conversacional del nivel siguiente: una capa de gestión visual, opcional, para los equipos que quieran ir un poco más lejos. Como cualquier sistema de información, se compone de dos partes. El back-end es un pequeño servidor, un programa liviano que corre en la propia computadora del auditor, sin depender de infraestructura del organismo ni de conexión a servicios externos, que lee la base de datos del expediente y calcula el estado actualizado de cada programa de trabajo cada vez que se le pide. El front-end es la pantalla: un tablero que se abre en el navegador de uso cotidiano y traduce esos datos en cuadros de avance, semáforos de cumplimiento y el seguimiento de la Hoja de Resúmen de Diferencias, sin que el usuario tenga que interactuar con ninguna consulta ni archivo técnico3. En el caso de LA MUNICIPALIDAD, esta capa se implementó como un tablero local de seguimiento de los ocho programas de auditoría estándar, sus ajustes presupuestarios y la Hoja de Relevamiento de Datos.
La diferencia de fondo con el nivel conversacional es de propósito, no de resultado. El agente resuelve tareas puntuales bajo pedido; el tablero ofrece una vista permanente y compartible del estado del expediente, útil para que el auditor de campo, el Gerente General y el Auditor de Área miren exactamente el mismo panorama sin que cada uno tenga que reconstruirlo por su cuenta ni depender de que el resumen de ayer siga vigente hoy. Por eso es una herramienta pensada para equipos con mayor interés o acompañamiento técnico, y no un requisito para obtener los beneficios centrales descriptos en las secciones anteriores. Para evitar que el auditor deba realizar tareas manuales de carga de datos, las mismas skills que generan cada papel de trabajo incluyen la instrucción de registrar, en la base de datos que almacena el seguimiento de los programas de auditoría, la ejecución de cada procedimiento. De ese modo, el tablero del sistema muestra en tiempo real qué procedimiento se ejecutó, a qué papel de trabajo quedó vinculado, en qué fecha y qué auditor fue responsable. Para poner en marcha este nivel no hace falta saber programar: cuando el agente indica que necesita instalar Python y genera un archivo .py para cargar los CSV a la base, ese archivo es apenas una receta escrita, de la misma familia que una fórmula de planilla, que se puede volver a ejecutar en segundos cada vez que llega información nueva. Conviene guardarlo como parte del legajo de papeles de trabajo, por la misma razón que ya vimos con las consultas SQL del cotejo bancario: si alguna vez alguien necesita entender cómo se pasó del extracto bancario a la base de datos, ese archivo es la prueba de qué transformación se aplicó, aunque no haga falta leerlo línea por línea.
5.8. El historial de cambios: control de versiones aplicado a reglas, skills y scripts
Guardar el script de carga como parte del legajo resuelve la trazabilidad de un archivo puntual. Pero la Regla, las skills y los scripts del expediente de LA MUNICIPALIDAD no son documentos estáticos: cambian con el tiempo, a medida que el criterio institucional se ajusta o se corrige un error detectado en el trabajo de campo. La skill de cotejo bancario, por ejemplo, se corrigió dos veces desde el inicio del ejercicio, lo que planteó una inquietud distinta a las anteriores: si alguien preguntara, meses después, con qué versión de la skill se hizo el cotejo de agosto, no había forma de saberlo con certeza.
Ese es el problema que resuelve un control de versiones, Git en este caso: una herramienta gratuita y de código abierto, creada en 2005 por Linus Torvalds (el mismo creador de Linux) para coordinar el trabajo de miles de programadores sobre un mismo código sin pisarse entre sí, y hoy el estándar de facto de toda la industria del software. Cada vez que se modifica una skill, un script o el archivo de reglas, se guarda un registro con la fecha, quién hizo el cambio y por qué; no se sobrescribe el archivo anterior, queda conservado y disponible para siempre, en una carpeta oculta dentro del propio expediente, sin necesidad de servidor ni de escribir comandos. Buscar en el historial la fecha de agosto alcanza para recuperar la versión exacta de la skill tal como estaba ese día, con la misma lógica que ya se aplicó al dejar visibles las consultas SQL en el Papel de Trabajo: no alcanza con el resultado final, hay que poder reconstruir con qué reglas se llegó a él. Su función aquí es doble. Es el mecanismo técnico que hace cierta la afirmación de que una skill "es versionable", y a la vez la mitigación concreta del riesgo de alteración no controlada del código que sostiene una skill, ya que un historial completo permite reconstruir quién modificó una consulta SQL o un script de carga, cuándo y con qué justificación.
El control de versiones es, además, el soporte técnico concreto de la revisión por pares que este trabajo ya adoptó para el código de auditoría, siguiendo el criterio de Cancinos y Villegas (2025): antes de que un cambio en una skill se aplique al trabajo de campo, otro integrante del equipo puede revisar exactamente qué se modificó y aprobarlo o cuestionarlo antes de que entre en uso. Como la capa de gestión visual, es un peldaño opcional: un equipo puramente conversacional puede omitirlo sin perder las garantías de neutralidad y responsabilidad profesional que sí son irrenunciables.
Todo lo anterior resuelve el historial de cambios dentro de un mismo expediente. Pero el propio ejercicio de LA MUNICIPALIDAD dejó planteada una pregunta que el control de versiones local no responde por sí solo: la skill de cotejo bancario, ya corregida y versionada en ese expediente, no le sirve de nada al equipo que audita otro municipio en paralelo si no tiene forma de enterarse de la mejora; cada expediente termina siendo una isla. Ahí hace falta un repositorio central del organismo, del que cada expediente parta como copia de trabajo: cuando un equipo mejora una skill, propone el cambio, un responsable designado lo revisa y, si lo aprueba, queda disponible para todos los expedientes nuevos. Eso no implica subir la normativa a un servicio en internet: la misma tecnología puede correr en un servidor propio del organismo (herramientas livianas como Gitea o Forgejo), la misma lógica que se aplica a los modelos de lenguaje locales para no sacar información sensible del organismo.
Esquema 4. Repositorio institucional y flujo de propuesta, revisión y propagación de cambios
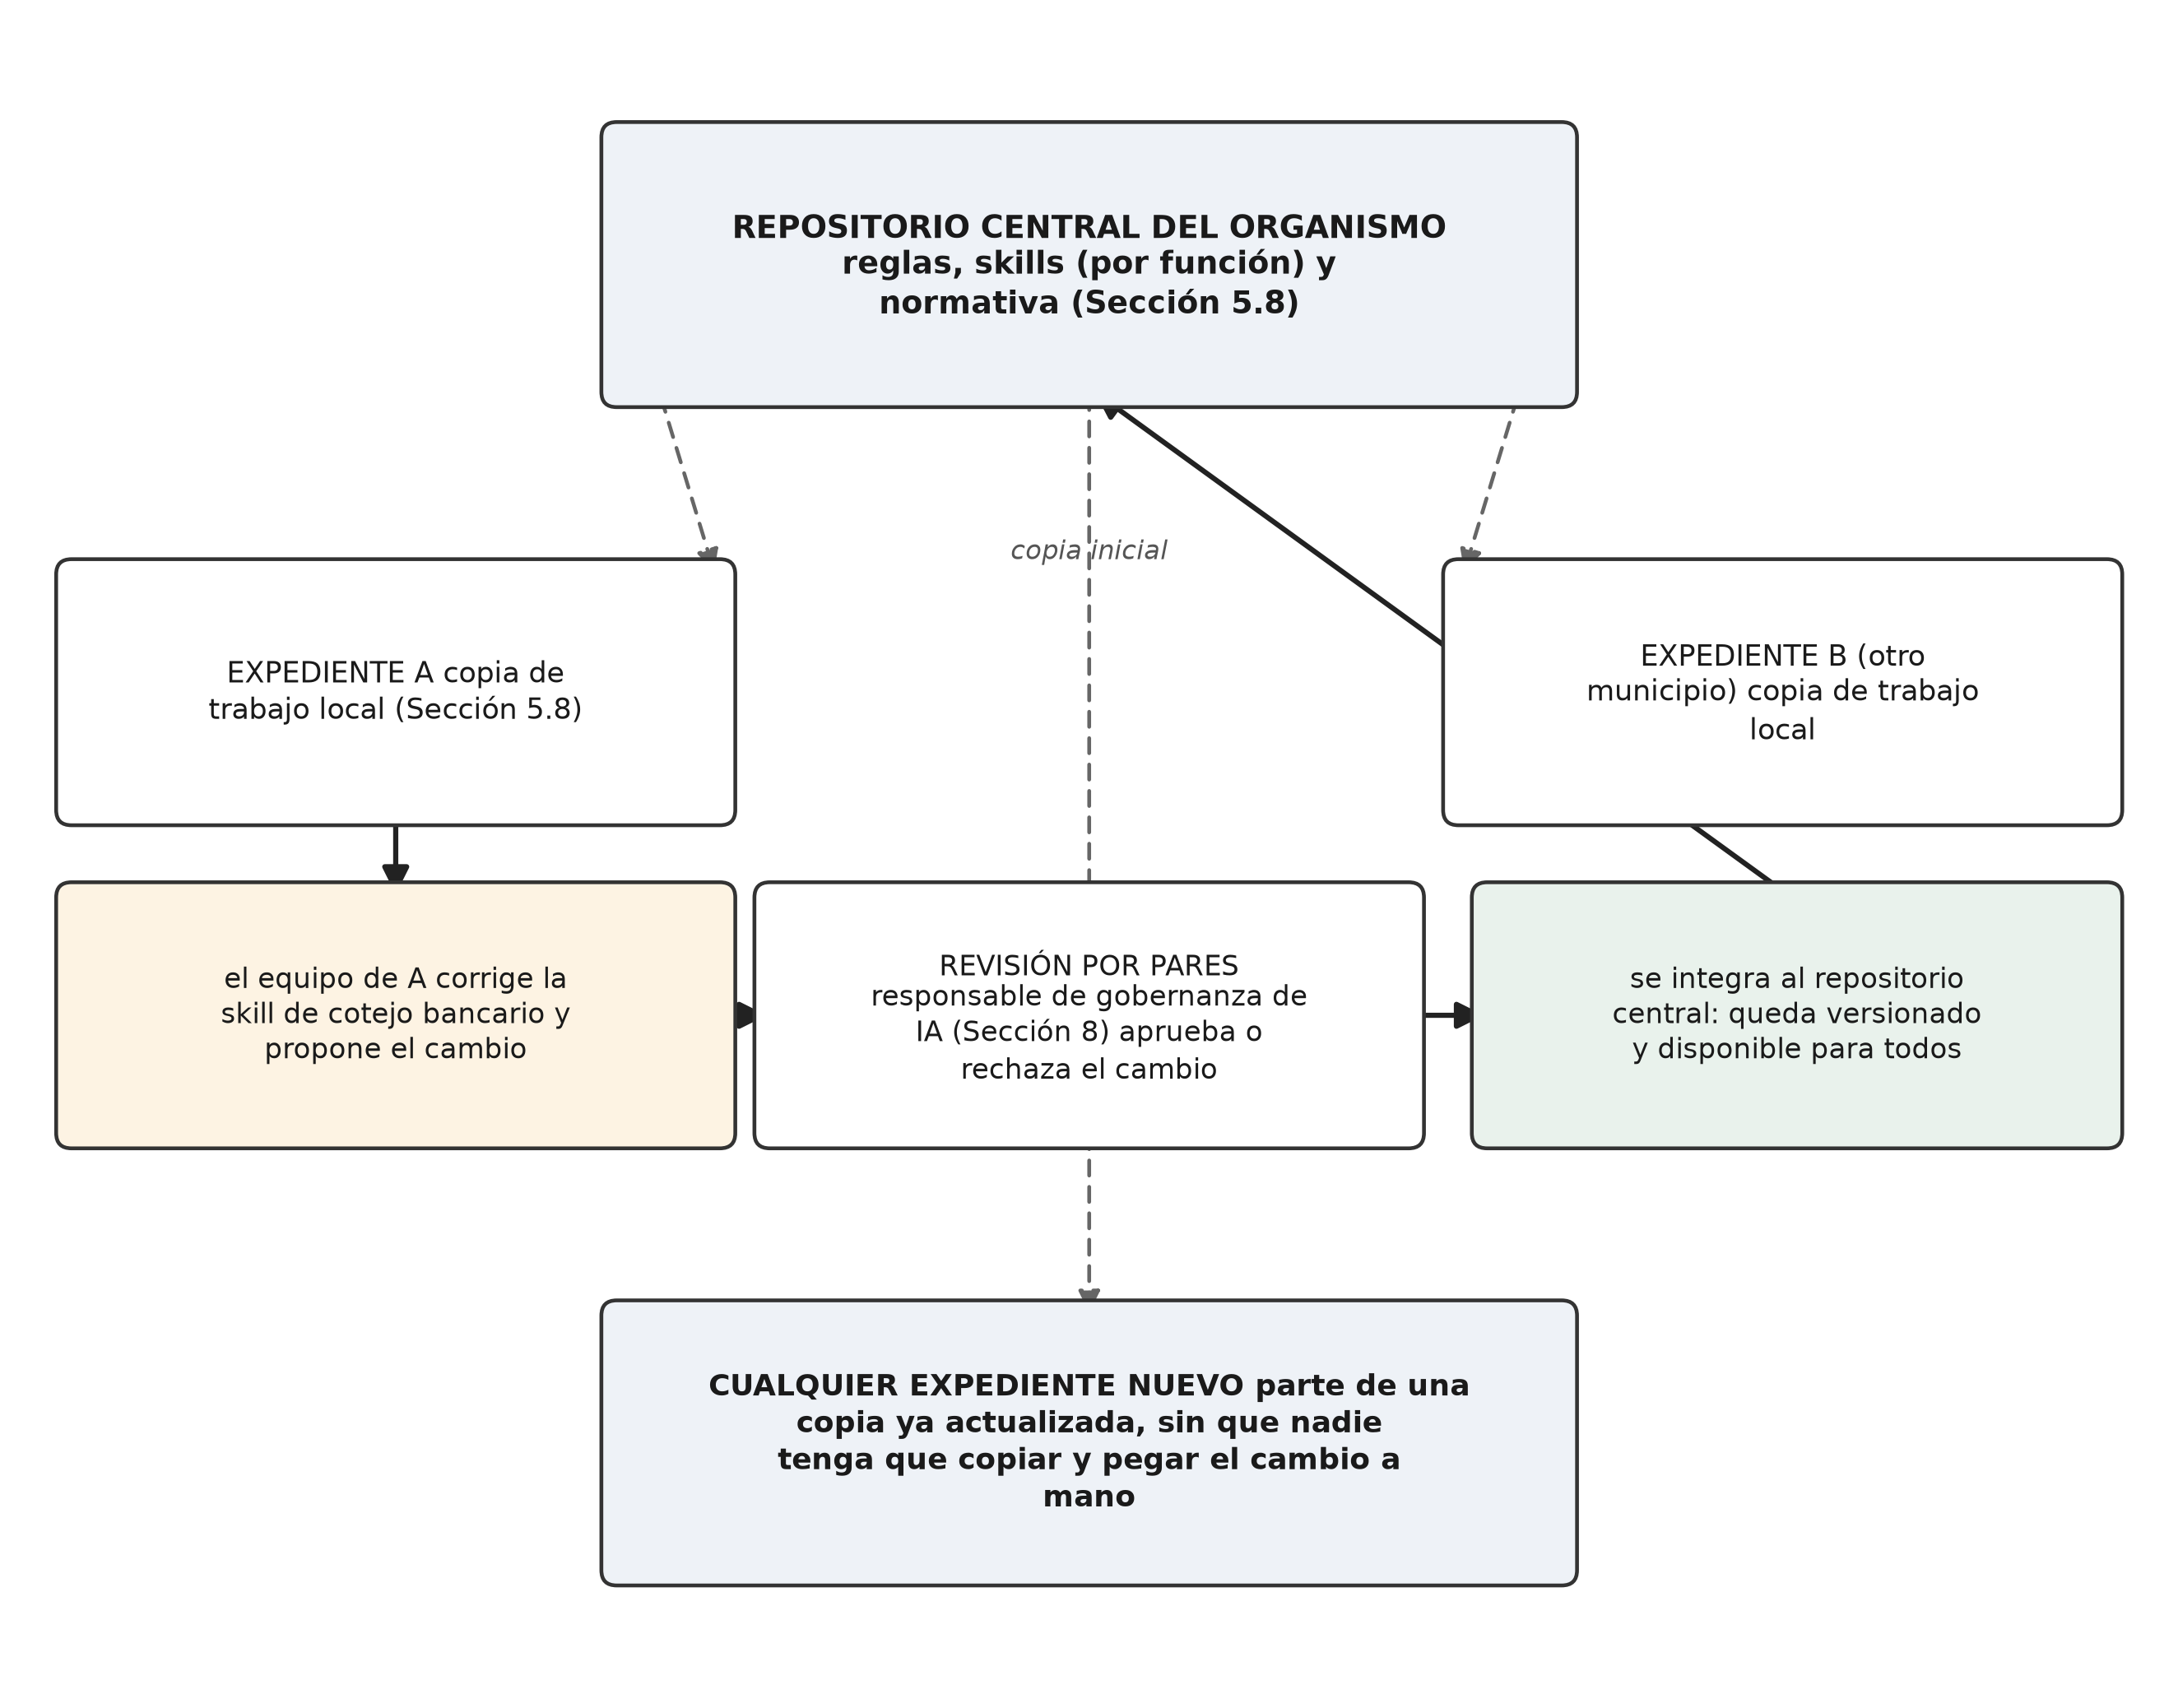
Un repositorio institucional de este tipo es la extensión, a escala de organismo, del mismo mecanismo descripto para el expediente: carpetas de primer nivel para reglas (la Regla base del organismo y sus variantes por tipo de ente), skills (catalogadas por función) y normativa, de modo que cada auditor que abre un expediente nuevo parta de una copia actualizada en lugar de heredar una versión desactualizada por correo electrónico o por una carpeta compartida sin control de cambios. La revisión de cada propuesta de cambio, antes de incorporarla al repositorio central, extiende esa misma revisión por pares a escala institucional: ningún criterio nuevo se generaliza a todo el organismo sin que un responsable designado lo revise y apruebe primero. Sea cual sea la herramienta concreta que un organismo elija, la función que debe cumplir es siempre la misma: que una mejora de criterio, detectada por un solo auditor en un solo expediente, se convierta en una mejora de todo el organismo sin que nadie tenga que copiarla y pegarla a mano.
6. Gobernanza, límites y responsabilidad profesional
6.1. La tensión entre la neutralidad del producto final y la transparencia del proceso
Con la misma franqueza con que se describieron los beneficios del enfoque, existe una tensión metodológica que este trabajo no pretende resolver del todo, sino dejar planteada para el debate. La regla de comportamiento ya descripta instruye que la documentación formal de auditoría no contenga referencias a su proceso de generación asistida, de manera que el papel de trabajo, la hoja de hallazgos, la observación y el informe se presenten bajo la exclusiva autoría del auditor que las suscribe. Esto es, por lo demás, jurídicamente correcto: el producto de auditoría no es "de la herramienta", es del profesional que lo controló, validó y firmó.
Las recomendaciones del Comité de Ética en Publicación (COPE Council, 2024) y la Declaración de Heredia sobre uso de inteligencia artificial en la edición científica (Penabad-Camacho et al., 2024), hoy adoptadas como estándar por buena parte de la comunidad académica y editorial, exigen en cambio lo contrario para un trabajo que se somete a evaluación científica o técnica: declarar expresamente el uso de herramientas de IA generativa, identificando qué modelo se utilizó y cómo fue implementado. Estas dos exigencias no son contradictorias, pero conviven en planos distintos. El producto de auditoría (el informe que se eleva a un Concejo Deliberante o a un Tribunal de Cuentas) se rige por la responsabilidad profesional del auditor firmante y no necesita exponer su proceso interno de elaboración, de la misma manera que un informe no expone qué procesador de texto o qué planilla de cálculo se usó para redactarlo. El trabajo académico sobre la metodología de auditoría, en cambio, tiene como objeto de estudio precisamente ese proceso; allí la transparencia sobre el uso de IA no es opcional, es constitutiva del propio trabajo.
6.2. Riesgos: alucinación, sesgo de automatización y pérdida de criterio profesional
Un framework de este tipo no está exento de riesgos, y omitirlos sería contrario al rigor científico que este trabajo se propone sostener. La literatura sobre inteligencia artificial en auditoría señala limitaciones como la transparencia y explicabilidad, los sesgos algorítmicos, la privacidad de los datos, la robustez de los sistemas y la ausencia de lineamientos regulatorios. En línea con ellas, este trabajo reconoce ocho riesgos principales, con su mitigación observada en la práctica, resumidos en la Tabla 4 antes de desarrollar en detalle los de mayor peso argumentativo para este framework.
Tabla 4. Riesgos identificados y mitigación observada en la práctica
| Riesgo | Mitigación observada | Referencia |
|---|---|---|
| Alucinación de evidencia o de referencias normativas | Cada skill de redacción exige enlace verificable al archivo fuente dentro del expediente digital; sin vínculo comprobable, no hay cita | OCDE, 2024 |
| Pérdida de criterio profesional en el mediano plazo | El auditor junior ejecuta el procedimiento manualmente al menos una vez antes de automatizarlo | Experiencia del autor |
| Robustez ante nuevos datos | Riesgo hoy acotado: las skills se apoyan en reglas y consultas determinísticas, no en modelos de aprendizaje automático; a prever si el framework evoluciona hacia analítica predictiva | NIST, 2024a, 2024b |
| Errores de extracción sobre documentación escaneada | Evitar el reconocimiento óptico de caracteres (OCR) donde exista fuente oficial estructurada; doble extracción independiente reportando solo discrepancias (misma lógica que el control estructural del hallazgo); exigir formato digital nativo donde el organismo tenga margen normativo | Sánchez Agüero, 2025 |
| Alteración no controlada del código que sostiene una skill | Control de versiones y revisión por pares antes de la puesta en uso operativo, extendiendo al propio código la misma lógica de revisión y no solo a la interpretación de sus resultados | Cancinos y Villegas, 2025 |
| Sesgo de automatización | Separación de roles entre quien ejecuta el procedimiento y quien supervisa el resultado | Rivera, 2023, cit. en Villegas y Kostrencic, 2024 |
| Soberanía y confidencialidad de los datos | Modelos de lenguaje locales u on-premise para expedientes o etapas con información especialmente sensible, evitando la salida de datos hacia infraestructura de terceros | Palmieri y Pérez, 2024 |
| Falta de lineamientos regulatorios sobre el uso de IA en auditoría | Mientras se consolida un marco normativo específico para la auditoría externa, la Regla y la separación de roles del framework actúan como sustituto transitorio | Criado, 2024 |
Sesgo de automatización (automation bias). Existe el riesgo de que el equipo auditor deposite una confianza excesiva en el resultado automatizado y reduzca su escepticismo profesional. La literatura sobre auditoría algorítmica distingue varias manifestaciones: el sesgo de datos (información no representativa del universo bajo análisis), el sesgo algorítmico (inherente al diseño del modelo) y el sesgo de confirmación, quizás el más sutil, que ocurre cuando el sistema tiende a confirmar las hipótesis que el propio auditor ya tenía en lugar de someterlas a contraste (Rivera, 2023, citado en Villegas y Kostrencic, 2024). Este último es particularmente relevante aquí, porque nada impide que un prompt sesgado ("confirmame que esta cuenta no tiene desvíos") induzca al agente a confirmar antes que a verificar. La mitigación no es tecnológica sino organizacional: la separación de roles entre quien ejecuta el procedimiento y quien supervisa el resultado, sin que ninguna conclusión se traslade al informe definitivo sin la validación expresa del auditor y del supervisor.
Soberanía y confidencialidad de los datos del expediente. Este es, tal vez, el riesgo más estructural del conjunto. Buena parte de las herramientas de IA generativa disponibles hoy operan como servicios en la nube, y la información que se les suministra, incluidos datos económico-financieros y eventualmente personales de agentes públicos o proveedores, viaja fuera del perímetro del organismo de control hacia la infraestructura de un tercero. Esto plantea una tensión real entre la eficiencia operativa y el deber de confidencialidad del organismo. Para expedientes o etapas que involucren información especialmente sensible, la alternativa técnica es el uso de modelos de lenguaje locales u on-premise, que evitan por completo la salida de datos al costo de una menor capacidad de procesamiento. La alternativa no es teórica: el Tribunal de Cuentas de Mendoza ya la aplicó, con los modelos LM Studio y Llama-3 ejecutados sin conexión a internet, para analizar pólizas de seguro y patentes de vehículos oficiales sin que la información saliera del organismo (Palmieri y Pérez, 2024). Este trabajo no pretende haber resuelto esta tensión de manera definitiva; la identifica, simplemente, como una decisión de gobernanza pendiente.
Falta de lineamientos regulatorios sobre el uso de IA en auditoría. La mayoría de las organizaciones de auditoría aún no cuentan con normativa específica que regule el uso de IA en el proceso de control. Los estudios comparados sobre IA en la administración pública latinoamericana identifican esta ausencia como uno de los desafíos centrales de la agenda regional (Criado, 2024); ya en 2019 la Declaración de Moscú de la Organización Internacional de Entidades Fiscalizadoras Superiores (INTOSAI) había instado a formar auditores capaces de utilizar herramientas de IA y análisis de datos (INTOSAI, 2019), recomendación que seis años después sigue sin traducirse en lineamientos concretos en la mayoría de los organismos de la región.
Cabe una salvedad para el caso argentino, hoy menos acotado. A nivel nacional existen ya la Disposición N.º 2/2023 de la Jefatura de Gabinete de Ministros (JGM) sobre "Recomendaciones para una Inteligencia Artificial Fiable" (Subsecretaría de Tecnologías de la Información - JGM, 2023), el "Programa de Transparencia y Protección de Datos Personales en el Uso de la IA" de la Agencia de Acceso a la Información Pública (Agencia de Acceso a la Información Pública, 2023), y desde junio de 2026 la Resolución SIGEN N.º 197/2026, que aprobó una "Guía de Controles Inteligencia Artificial" de aplicación obligatoria para el Sector Público Nacional, con un enfoque basado en riesgo (Sindicatura General de la Nación, 2026); sigue, no obstante, centrada en el control interno del Poder Ejecutivo y no en la función de auditoría externa.
A nivel provincial, la Resolución N.º 02/2026 de la Secretaría de Modernización de Salta aprobó un protocolo de uso responsable de IA exigible al Poder Ejecutivo provincial (Secretaría de Modernización y Servicios Públicos de Salta, 2026). Más significativo para este trabajo es el antecedente municipal: la Ordenanza N.º 16537 del Concejo Deliberante de la Ciudad de Salta alcanza expresamente al Tribunal de Cuentas Municipal (artículo 2°) y establece, entre sus disposiciones, la supervisión humana obligatoria de todo sistema de IA (artículo 5°), el derecho de los ciudadanos a solicitar la revisión humana de una decisión asistida por IA y una explicación comprensible de los criterios y datos utilizados por el algoritmo (artículo 9°), y salvaguardas específicas de protección de datos personales frente al uso de sistemas de IA (artículo 8°) (Concejo Deliberante de la Ciudad de Salta, 2026). Constituye, según la revisión realizada para este trabajo, uno de los primeros antecedentes normativos argentinos que menciona expresamente a un organismo de control externo dentro de una regulación de IA, y sus disposiciones son, en buena medida, una expresión normativa de los mismos principios que la Regla y la separación de roles de este framework ya incorporaban. Fuera de estos antecedentes puntuales, la ausencia de lineamientos propios de la auditoría sigue siendo el escenario predominante, y la Regla y la separación de roles actúan, mientras tanto, como sustituto transitorio de esa normativa aún inexistente.
6.3. El auditor como responsable último de la evidencia y la conclusión
La incorporación de agentes de inteligencia artificial no introduce una responsabilidad nueva. Es la misma responsabilidad profesional que ya rige la firma del auditor sobre el informe que suscribe, con independencia de qué herramientas (una calculadora, una planilla de cálculo, un sistema de gestión de expedientes o un agente de inteligencia artificial) haya utilizado en su elaboración. Ninguna herramienta firma un informe de auditoría; lo firma un profesional que la utilizó, la controló y asumió sus conclusiones como propias. Si se implementa correctamente, el framework aquí descripto hace esa responsabilidad más verificable.
La doctrina especializada en derecho administrativo ha propuesto el concepto de reserva de humanidad para nombrar este límite. Existen dimensiones de la decisión pública que deben permanecer bajo el ámbito indelegable del juicio humano: las que exigen ponderar circunstancias singulares, valorar descargos, o formular lo que en la lógica del razonamiento se conoce como inferencias abductivas, no meramente deductivas o inductivas. Esto no responde a un déficit transitorio de la tecnología disponible, sino a una decisión de Estado de Derecho sobre qué ámbitos de la función pública no corresponde automatizar (Ponce Solé, 2024). Aplicado a este framework, la reserva de humanidad es el fundamento mismo de por qué la Regla reserva a las skills la ejecución de tareas regladas (cotejos, controles estructurales, verificaciones de formato) y confía exclusivamente al auditor la interpretación de la causa, la ponderación del riesgo y la conclusión final sobre el hallazgo. Ese es, en definitiva, el límite que este trabajo no está dispuesto a cruzar.
7. Resultados y discusión
La sistematización descripta permite identificar varios hallazgos cualitativos del ejercicio experimental que sustenta este trabajo, a los que se suma una autocrítica necesaria sobre el alcance actual del enfoque. No se presentan aquí como resultados medidos, sino como observaciones del propio ejercicio, sujetas a la validación cuantitativa sobre casos reales que se propone como línea futura en las conclusiones:
Primero, una reducción perceptible, aunque no medida ni cuantificada en este trabajo, del tiempo dedicado a procedimientos mecánicos y repetitivos (cotejos, conciliaciones, verificaciones estructurales de formato), según lo observado en los procedimientos ya descriptos durante el ejercicio. No es posible, con la evidencia disponible, afirmar en qué proporción se redujo ese tiempo ni si esa reducción se sostiene en expedientes de otra complejidad; lo que sí puede sostenerse, porque se observó de manera directa en el caso del cotejo bancario, es que el tiempo liberado en ese cotejo puntual se reorientó hacia el análisis de causa raíz, y no simplemente hacia otra tarea mecánica.
Segundo, una mayor consistencia percibida del criterio técnico entre distintos miembros del equipo y entre distintos expedientes. El conocimiento institucional (qué normativa aplica, cómo se estructura un hallazgo, qué constituye una limitación al alcance frente a una observación sustantiva) deja de depender exclusivamente de la memoria o la experiencia individual de cada auditor y se codifica en un artefacto compartido, revisable y mejorable de manera colectiva.
Tercero, lo que podría llamarse una trazabilidad multinivel, que atraviesa transversalmente el framework en cuatro capas distintas. Las consultas SQL documentadas palabra por palabra en cada papel de trabajo dejan constancia de qué cifra se usó. Las skills conservadas y versionadas dejan constancia de qué versión del procedimiento se aplicó. La Memoria de Supervisión deja constancia de qué controles se verificaron. Y el historial de cambios de la Regla y el repositorio institucional dejan constancia de quién cambió un criterio y cuándo. En conjunto, estas cuatro capas reemplazan la revisión manual de checklists extensas, inherentemente propensa al error de omisión, por un rastro documental verificable en cada etapa del proceso.
Cuarto, y a modo de autocrítica: conviene situar el estado actual del framework dentro de la distinción habitual entre tipos de analítica de datos, descriptiva (qué y cómo es), diagnóstica (por qué sucedió así), predictiva (qué va a pasar) y prescriptiva (qué curso de acción tomar). Las skills relevadas en este trabajo, el cotejo bancario, el control estructural C.C.C.E., la memoria de supervisión, operan hoy casi exclusivamente en el plano descriptivo y diagnóstico. Reconstruyen con precisión qué ocurrió y, en el caso del cotejo, por qué (descarte de hipótesis de anulación bancaria), pero no anticipan dónde es más probable que aparezca un desvío antes de que el equipo audite esa partida. La incorporación de capacidades predictivas y prescriptivas, por ejemplo un modelo que priorice qué cuentas o programas presupuestarios auditar en función de su historial de desvíos, es un horizonte de desarrollo todavía no explorado por este trabajo, que se retoma como línea futura en las conclusiones.
Estos resultados deben leerse, sin embargo, con la cautela metodológica propia de un estudio de caso. Estos resultados provienen de la sistematización reflexiva de un ejercicio experimental de diseño metodológico sobre datos sintéticos, y no de una medición cuantitativa sobre expedientes reales ni de un experimento con grupo de control. Generalizar estos resultados a otros organismos del Secretariado Permanente de Tribunales de Cuentas, Órganos y Organismos Públicos de Control Externo de la República Argentina (SPTCRA) requeriría, como se propone en la sección siguiente, un proceso de validación colectiva a nivel federal.
La lógica de sistematizar procedimientos de auditoría en unidades reutilizables no es, de todos modos, una idea aislada de este trabajo. El Tribunal de Cuentas de la Unión de Brasil opera desde hace años un ecosistema propio: "Labcontas" ejecuta tipologías de riesgo predefinidas sobre licitaciones y contrataciones, y "Sofía" es un asistente que permite acceder y analizar información dispersa en las bases del organismo, ambas con una función análoga a la de las skills descriptas en este trabajo. La Contraloría de Colombia desarrolló la DIARI para el cruce sistemático de bases públicas con fines de alerta temprana. Estos antecedentes, relevados por OLACEFS-BID (2021), muestran que la generalización propuesta se apoya en una tendencia regional ya en marcha; la propia Auditoría General de la Nación participa de ella desde un lugar de liderazgo, con su auditor general presidiendo la Comisión de Tecnologías de la Información y Comunicaciones de la OLACEFS (CTIC-OLACEFS, 2024), lo que sugiere que el SPTCRA puede apoyarse en canales institucionales ya activos.
Fuera de la región, la Corte de Cuentas Europea (ECA) formalizó un enfoque dual afín a la distinción de este trabajo entre "auditar la IA" e "IA para auditar": capacitar a su personal para fiscalizar el uso de IA en la administración pública europea, y dotar a la propia Corte de herramientas internas (un asistente de borradores, un buscador semántico y un chatbot sobre su repositorio metodológico) equivalentes a las skills de redacción y consulta ya descriptas (Corte de Cuentas Europea, 2024).
Tampoco faltan antecedentes nacionales fuera del control externo: Prometea, en el Poder Judicial argentino, y Laura, de la Administración Nacional de la Seguridad Social (ANSES), para la determinación de aportes jubilatorios (Campos Acuña y Vestri, 2024). El antecedente más cercano en tipo de organismo es el Tribunal de Cuentas Municipal de Santa Fe, que hizo una prueba piloto con un asistente de uso general (NotebookLM®) sobre cuatro tareas de control externo, con resultados calificados de positivos por los propios autores (Gueseloff y Pastore, 2025). La diferencia con el enfoque aquí propuesto está en la arquitectura utilizada, más que en el resultado obtenido: esa prueba se apoyó en una herramienta genérica sin codificar el conocimiento institucional en unidades persistentes y versionables, mientras que este framework busca que esos resultados dejen de depender de la calidad del prompt de cada sesión.
8. Conclusiones y recomendaciones
Este trabajo sostuvo que la auditoría en el sector público puede beneficiarse de una arquitectura de conocimiento tomada de la ingeniería de software (reglas, procedimientos reutilizables o skills, y agentes de rol acotado), bajo el principio rector planteado desde el Resumen: el framework automatiza tareas, no delega la responsabilidad profesional. La evidencia de campo sistematizada sugiere, por el contrario, que una arquitectura de este tipo, correctamente gobernada, refuerza esa responsabilidad en lugar de diluirla, porque hace trazable cada vínculo entre hallazgo, evidencia y normativa aplicable.
De esa experiencia se desprenden algunas líneas de acción concretas para los organismos de control externo que evalúen adoptar un enfoque similar:
-
Codificar el criterio técnico institucional de forma explícita y compartible, más allá de qué herramienta se use para ejecutarlo, dejando de depender de la transmisión oral o la imitación de informes anteriores. Un repositorio de criterios técnicos codificados es un activo institucional que podría compartirse entre organismos del país sin comprometer la autonomía normativa de cada jurisdicción. Este trabajo propone un mecanismo concreto: un repositorio de control de versiones institucional, alojado en infraestructura propia, del que cada expediente parte como copia de trabajo.
-
Separar con claridad, en la política interna de cada organismo, la neutralidad exigida al producto de auditoría de la transparencia exigida al proceso que le dio origen, de modo que ambas exigencias convivan sin interpretaciones contradictorias entre el informe de auditoría, la publicación académica y la rendición ante el propio organismo.
-
Impulsar capacitación continua sobre gobernanza de agentes de IA aplicados al control externo, con énfasis en los riesgos ya señalados, incorporando los criterios de infraestructura y capacidades institucionales de la Carta Iberoamericana de Inteligencia Artificial en la Administración Pública, del Centro Latinoamericano de Administración para el Desarrollo (CLAD, 2023). Antes de escalar un framework de este tipo, un organismo no necesita partir de cero: el LOTA Scan de la INTOSAI Development Initiative (IDI) y el Working Group on Impact of Science and Technology on Auditing (WGISTA) permiten a una EFS relevar su propia madurez tecnológica antes de definir proyectos piloto (INTOSAI Development Initiative, 2024).
-
Extender la auditoría de algoritmos también hacia adentro. Así como el control externo empieza a evaluar los sistemas de los entes auditados, los propios organismos deberían someter a un escrutinio equivalente las herramientas de IA que incorporen a su trabajo.
-
Abordar la gobernanza de la IA integrando formalmente los principios que guían su uso en la normativa del organismo, asegurando la transparencia y auditabilidad del propio uso en línea con el control estructural ya descripto, y evaluando, si el framework escala más allá de un equipo piloto, la designación de un responsable institucional de gobernanza de IA, análogo al Chief Artificial Intelligence Officer de otros ámbitos del sector público (Campos Acuña y Vestri, 2024). La Guía del Centro de Implementación de Políticas Públicas para la Equidad y el Crecimiento (CIPPEC) para el uso de IA en el sector público argentino ofrece un punto de partida ya adaptado al contexto local (Solano et al., 2025), y la Resolución SIGEN N.º 197/2026 confirma que este tipo de gobernanza integral ya tiene antecedente obligatorio para el control interno nacional.
-
Evaluar la incorporación de modelos de lenguaje locales u on-premise para el tratamiento de información especialmente sensible del expediente, reduciendo la dependencia de servicios en la nube de terceros donde la confidencialidad lo amerite.
-
Presentar la adopción de este tipo de herramientas como un camino gradual. El nivel conversacional alcanza la mayor parte del beneficio sin requerir formación en programación; la capa de gestión visual debe ofrecerse como opción para equipos con mayor interés técnico, acompañada de material introductorio en lenguaje llano.
-
Explorar, como siguiente etapa, la incorporación de analítica predictiva y prescriptiva sobre la base de datos del expediente, por ejemplo modelos que prioricen qué cuentas o partidas auditar según su historial de desvíos, atendiendo desde el diseño a los riesgos ya señalados. Los algoritmos de detección de anomalías por aislamiento (Isolation Forest) ya fueron aplicados por otro Tribunal de Cuentas argentino sobre más de 250.000 registros de proveedores del Estado (Palmieri y Pérez, 2024), y podrían adaptarse a las bases de datos del expediente ya descriptas.
-
Diseñar, en una segunda etapa de implementación, una medición cuantitativa del impacto del framework (horas insumidas antes y después por procedimiento, cantidad de observaciones detectadas por el control estructural, tasa de discrepancias resueltas en la conciliación bancaria) que permita contrastar empíricamente los hallazgos cualitativos aquí reportados, hoy basados en el ejercicio experimental descripto y no en una medición sistemática sobre casos reales.
Incorporar esta tecnología es la parte fácil. Lo que determina si funciona es la gobernanza que cada organismo construya sobre cómo esa tecnología se usa, se documenta y se somete, ella misma, al escrutinio profesional que define la esencia de la función de auditoría.
Es lunes de nuevo, un año después de la escena con que abrió este trabajo. La carpeta del expediente vuelve a estar abierta en dos pantallas, pero ya no de la misma manera. En una, el legajo del municipio bajo examen; en la otra, ya no una consulta armada desde cero, sino una que corre sobre una base construida el primer día de campo, con la Regla, los metadatos y las skills del organismo cargadas de antemano. La diferencia de saldo entre un libro mayor y un extracto bancario sigue apareciendo, mes tras mes, cuenta tras cuenta, como apareció siempre. Lo que cambió no es la pregunta que un auditor se hace frente a esa diferencia, sigue siendo la misma pregunta humana de siempre, sino cuánto de la mecánica que rodea a esa pregunta quedó, por fin, escrita una sola vez.
9. Bibliografía
Agencia de Acceso a la Información Pública. (2023). Resolución N.º 161/2023, Programa de Transparencia y Protección de Datos Personales en el Uso de la Inteligencia Artificial. Boletín Oficial de la República Argentina, 4 de septiembre de 2023. https://www.boletinoficial.gob.ar/detalleAviso/primera/293363/20230904
Anthropic. (2026). Effective harnesses for long-running agents. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
Campos Acuña, C., y Vestri, G. (2024). Inteligencia Artificial en el sector público: retos pendientes. LA LEY Soluciones Legales S.A.
Cancinos, A. J., y Villegas, L. A. (2025). Auditoría Ágil y Segura: Desarrollo de Herramientas de Bajo Costo con Google Workspace para la Automatización de Acciones en Órganos de Control Externo [Ponencia]. XXVII Jornadas de Tribunales de Cuentas, Órganos y Organismos de Control Externo de la República Argentina, Mendoza.
Centro Latinoamericano de Administración para el Desarrollo. (2023). Carta Iberoamericana de Inteligencia Artificial en la Administración Pública. Aprobada en la LIII Reunión del Consejo Directivo del CLAD, Varadero, Cuba. https://clad.org/
Comisión de las Tecnologías de Información y Comunicaciones de la OLACEFS (CTIC-OLACEFS). (2024). Plan Operativo Anual 2024. Organización Latinoamericana y del Caribe de Entidades Fiscalizadoras Superiores. https://olacefs.com/ctic/document/poa-2024/
Concejo Deliberante de la Ciudad de Salta. (2026). Ordenanza N.º 16537, Marco regulatorio para la utilización de Inteligencia Artificial en la gestión pública municipal. Boletín Oficial Municipal de la Ciudad de Salta N.º 2793, 6 de mayo de 2026. https://municipalidadsalta.gob.ar/wp-content/uploads/2026/05/BOLETIN-No-2793-Fecha-de-Edicion-Miercoles-06-de-Mayo-2026-CONTIENE-FIRMA-DIGITAL.pdf
COPE Council. (2024). COPE position - Authorship and AI. Committee on Publication Ethics. https://doi.org/10.24318/cCVRZBms
Corte de Cuentas Europea (ECA). (2024). Artificial Intelligence initial strategy and deployment roadmap 2024-2025. https://www.sipotra.it/wp-content/uploads/2024/10/Artificial-intelligence-initial-strategy-and-deployment-roadmap-2024-2025.pdf
Criado, J. I. (2024). Inteligencia Artificial en el Sector Público latinoamericano. Estudio comparado a partir de la Carta Iberoamericana de Inteligencia Artificial en la Administración Pública. Revista del CLAD Reforma y Democracia, (88), 116-143. https://doi.org/10.69733/clad.ryd.n88.a387
Federación Argentina de Consejos Profesionales de Ciencias Económicas (FACPCE). (2022). Resolución Técnica N.º 37 y N.º 53, Normas de Auditoría, Revisión, Otros Encargos de Aseguramiento y Servicios Relacionados. https://www.facpce.org.ar/wp-content/uploads/2022/02/RESOLUCION_TECNICA_N%C2%B0_53.pdf
Google. (2026). Authoring Google Antigravity Skills [Codelab]. Google Developers. https://codelabs.developers.google.com/getting-started-with-antigravity-skills
Gueseloff, N., y Pastore, M. A. (2025). La Inteligencia Artificial como herramienta del control externo gubernamental: Desafíos y Oportunidades [Ponencia]. XXVII Jornadas del Secretariado Permanente de Tribunales de Cuentas, Órganos y Organismos Públicos de Control Externo de la República Argentina, Mendoza.
INTOSAI Development Initiative (IDI). (2024). LOTA Scan Guide. https://idi.no/wp-content/uploads/resource_files/lota-scan-guide-es.pdf
National Institute of Standards and Technology (NIST). (2024a). NIST.AI.600-1 — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. U.S. Department of Commerce. https://doi.org/10.6028/NIST.AI.600-1
National Institute of Standards and Technology (NIST). (2024b). NIST.AI.800-1 — Managing Misuse Risk for Dual-Use Foundation Models. U.S. Department of Commerce. https://doi.org/10.6028/NIST.AI.800-1.ipd
Organización para la Cooperación y el Desarrollo Económicos (OCDE). (2024). AI, data governance and privacy: Synergies and areas of international cooperation (OECD Artificial Intelligence Papers N.º 22). OECD Publishing. https://doi.org/10.1787/2476b1a4-en
Organización Internacional de Entidades Fiscalizadoras Superiores (INTOSAI). (2019). Declaración de Moscú. https://www.intosai.org/fileadmin/downloads/news/2019/10/SP_23_Moscow_Decl_300919.pdf
Organización Latinoamericana y del Caribe de Entidades Fiscalizadoras Superiores (OLACEFS) y Banco Interamericano de Desarrollo (BID). (2021). Mapeo de Iniciativas y Necesidades en Tecnología Digital, y de Uso de Datos e Innovación de la OLACEFS. https://olacefs.com/la-olacefs-y-el-bid-comparten-los-resultados-del-mapeo-de-necesidades-de-ti-en-las-efs/
Palmieri, M., y Pérez, P. A. (2024). Inteligencia Artificial, Aprendizaje Automático y Controles Automáticos aplicado a la Auditoría Contable [Ponencia]. XXVII Congreso de Tribunales de Cuentas, Órganos y Organismos Públicos de Control Externo de la República Argentina, Termas de Río Hondo, Santiago del Estero.
Parlamento Europeo y Consejo de la Unión Europea. (2024). Reglamento (UE) 2024/1689, por el que se establecen normas armonizadas en materia de inteligencia artificial.
Penabad-Camacho, L., Penabad-Camacho, M. A., Mora-Campos, A., Cerdas-Vega, G., Morales-López, Y., Ulate-Segura, M., Méndez-Solano, A., Nova-Bustos, N., Vega-Solano, M. F., y Castro-Solano, M. M. (2024). Declaración de Heredia: Principios sobre el uso de inteligencia artificial en la edición científica. Revista Electrónica Educare, 28(Extra 1). https://www.revistas.una.ac.cr/index.php/EDUCARE/article/view/19967/30780
Ponce Solé, J. (2024). Inteligencia artificial, decisiones administrativas discrecionales totalmente automatizadas y alcance del control judicial: ¿indiferencia, insuficiencia o deferencia? Revista de Derecho Público: Teoría y Método, 9, 171-220. https://doi.org/10.37417/RDP/vol_7_2024_2151
Sánchez Agüero, F. N. (2025). Viabilidad de la Inteligencia Artificial como Herramienta Tecnológica en el proceso de control de Redeterminaciones de Precios [Ponencia]. XXVII Jornadas de Tribunales de Cuentas, Órganos y Organismos de Control Externo de la República Argentina, Mendoza.
Secretaría de Modernización y Servicios Públicos de la Provincia de Salta. (2026). Resolución N.º 02/2026, Protocolo para la creación, implementación y uso responsable de agentes públicos de inteligencia artificial y herramientas de inteligencia artificial generativa. Boletín Oficial de la Provincia de Salta N.º 22197. https://boletinoficialsalta.gob.ar/instrumento.php?cXdlcnR5dGFibGE9QXwxMDAxMzY0ODImZGF0YT0yMjE5N3F3ZXJ0eQ==
Sindicatura General de la Nación (SIGEN). (2026). Resolución N.º 197/2026, Guía de Controles Inteligencia Artificial - SIGEN. Boletín Oficial de la República Argentina, 22 de junio de 2026. https://www.boletinoficial.gob.ar/detalleAviso/primera/343375/20260622
Solano, M., Estévez, E., y Peralta, A. (2025). Guía para el uso de IA en el sector público en Argentina. Centro de Implementación de Políticas Públicas para la Equidad y el Crecimiento (CIPPEC). https://www.cippec.org/wp-content/uploads/2025/05/Guia-para-el-uso-de-IA-en-el-sector-publico-en-Argentina_2025.pdf
Subsecretaría de Tecnologías de la Información - Jefatura de Gabinete de Ministros (JGM). (2023). Disposición N.º 2/2023 — Recomendaciones para una Inteligencia Artificial Fiable. https://servicios.infoleg.gob.ar/infolegInternet/anexos/380000-384999/384656/norma.htm
Villegas, L. A., y Kostrencic, C. del V. (2024). La Inteligencia Artificial como Soporte y Sujeto de Auditoría en la Actualidad [Ponencia]. XXVII Congreso Nacional de Tribunales de Cuentas, Órganos y Organismos Públicos de Control Externo de la República Argentina, Termas de Río Hondo, Santiago del Estero.
Notas
-
Gemini 3.5 fue utilizado para la producción de las skills del framework descriptas en esta sección; todo el contenido resultante fue revisado, corregido y validado por el autor antes de su incorporación al texto final. ↩
-
Gemma 4 fue utilizado para el procesamiento de los datos del expediente ilustrativo descripto en esta sección. ↩
-
Claude Opus 4.5 fue utilizado para el desarrollo del back-end y el front-end de la capa de gestión visual descripta en esta sección. ↩